做过GEO技术的同学都知道一个痛:内容量小的时候(几千篇),直接暴力计算相似度,毫秒级就出结果,感觉一切都很美好。等内容量涨到几十万、上百万条向量的时候,每次检索都要把所有向量算一遍相似度——响应时间从毫秒级掉到秒级甚至十几秒,系统直接就卡崩了。
这时候就需要索引。索引这件事,听起来好像就是"把数据存起来",但在向量检索领域,索引的设计直接决定了你的系统能不能扛住规模、能不能保证GEO监测的实时性。这篇文章我们就把GEO场景下的索引技术从原理到选型到调优讲透。
一、为什么需要索引:暴力搜索为什么不行
先算一笔账。假设你的内容库里有100万个向量,每个向量1024维。用户问一个问题,系统要算这个问题向量和100万个向量的余弦相似度——每次计算要做1024次乘法和加法。100万×1024 = 十亿级别的计算量。
就算你的服务器很强,单次查询也要几十到几百毫秒。如果同时有10个并发查询,CPU直接就打满了。这还只是100万条——如果是1000万条呢?根本扛不住。
索引的作用,就是通过预计算和数据结构优化,把"每次全量扫描"变成"定向查找"。 就像书后面的索引——你不用把整本书从头到尾翻一遍找某个词,直接查索引表就能定位到页码。
向量索引要解决的核心矛盾是:检索速度 vs 检索精度。 建索引的时候用了更激进的近似策略,速度就快,但可能漏掉一些本来相关的结果;用更保守的策略,精度高但速度慢。好的索引设计,就是在这两者之间找到最佳平衡点。
二、主流向量索引算法对比
目前GEO场景下常用的向量索引算法有这么几种,我们做个横向对比:
| 索引类型 | 原理 | 构建速度 | 查询速度 | 内存占用 | 精度 | 适合规模 |
|---|---|---|---|---|---|---|
| 暴力搜索(Flat) | 全量计算相似度 | 无需构建 | 最慢 | 最小 | 100% | <1万条 |
| IVF(倒排文件) | 先聚类成桶,只搜最近的几个桶 | 快 | 快 | 中等 | 略降 | 10万-100万 |
| HNSW(分层导航小世界图) | 建多层图结构,图上快速导航 | 中等 | 很快 | 较大 | 高 | 10万-千万级 |
| PQ(乘积量化) | 压缩向量降低维度 | 快 | 很快 | 最小 | 降较多 | 千万-亿级 |
GEO场景下最常用的是HNSW索引——它在速度和精度之间平衡得最好,也是现在主流向量数据库的默认索引方案。我们重点讲讲HNSW。
三、HNSW索引原理:为什么它又快又准
HNSW的全称是"分层导航小世界图"。这个名字听起来很玄,其实原理很好理解。
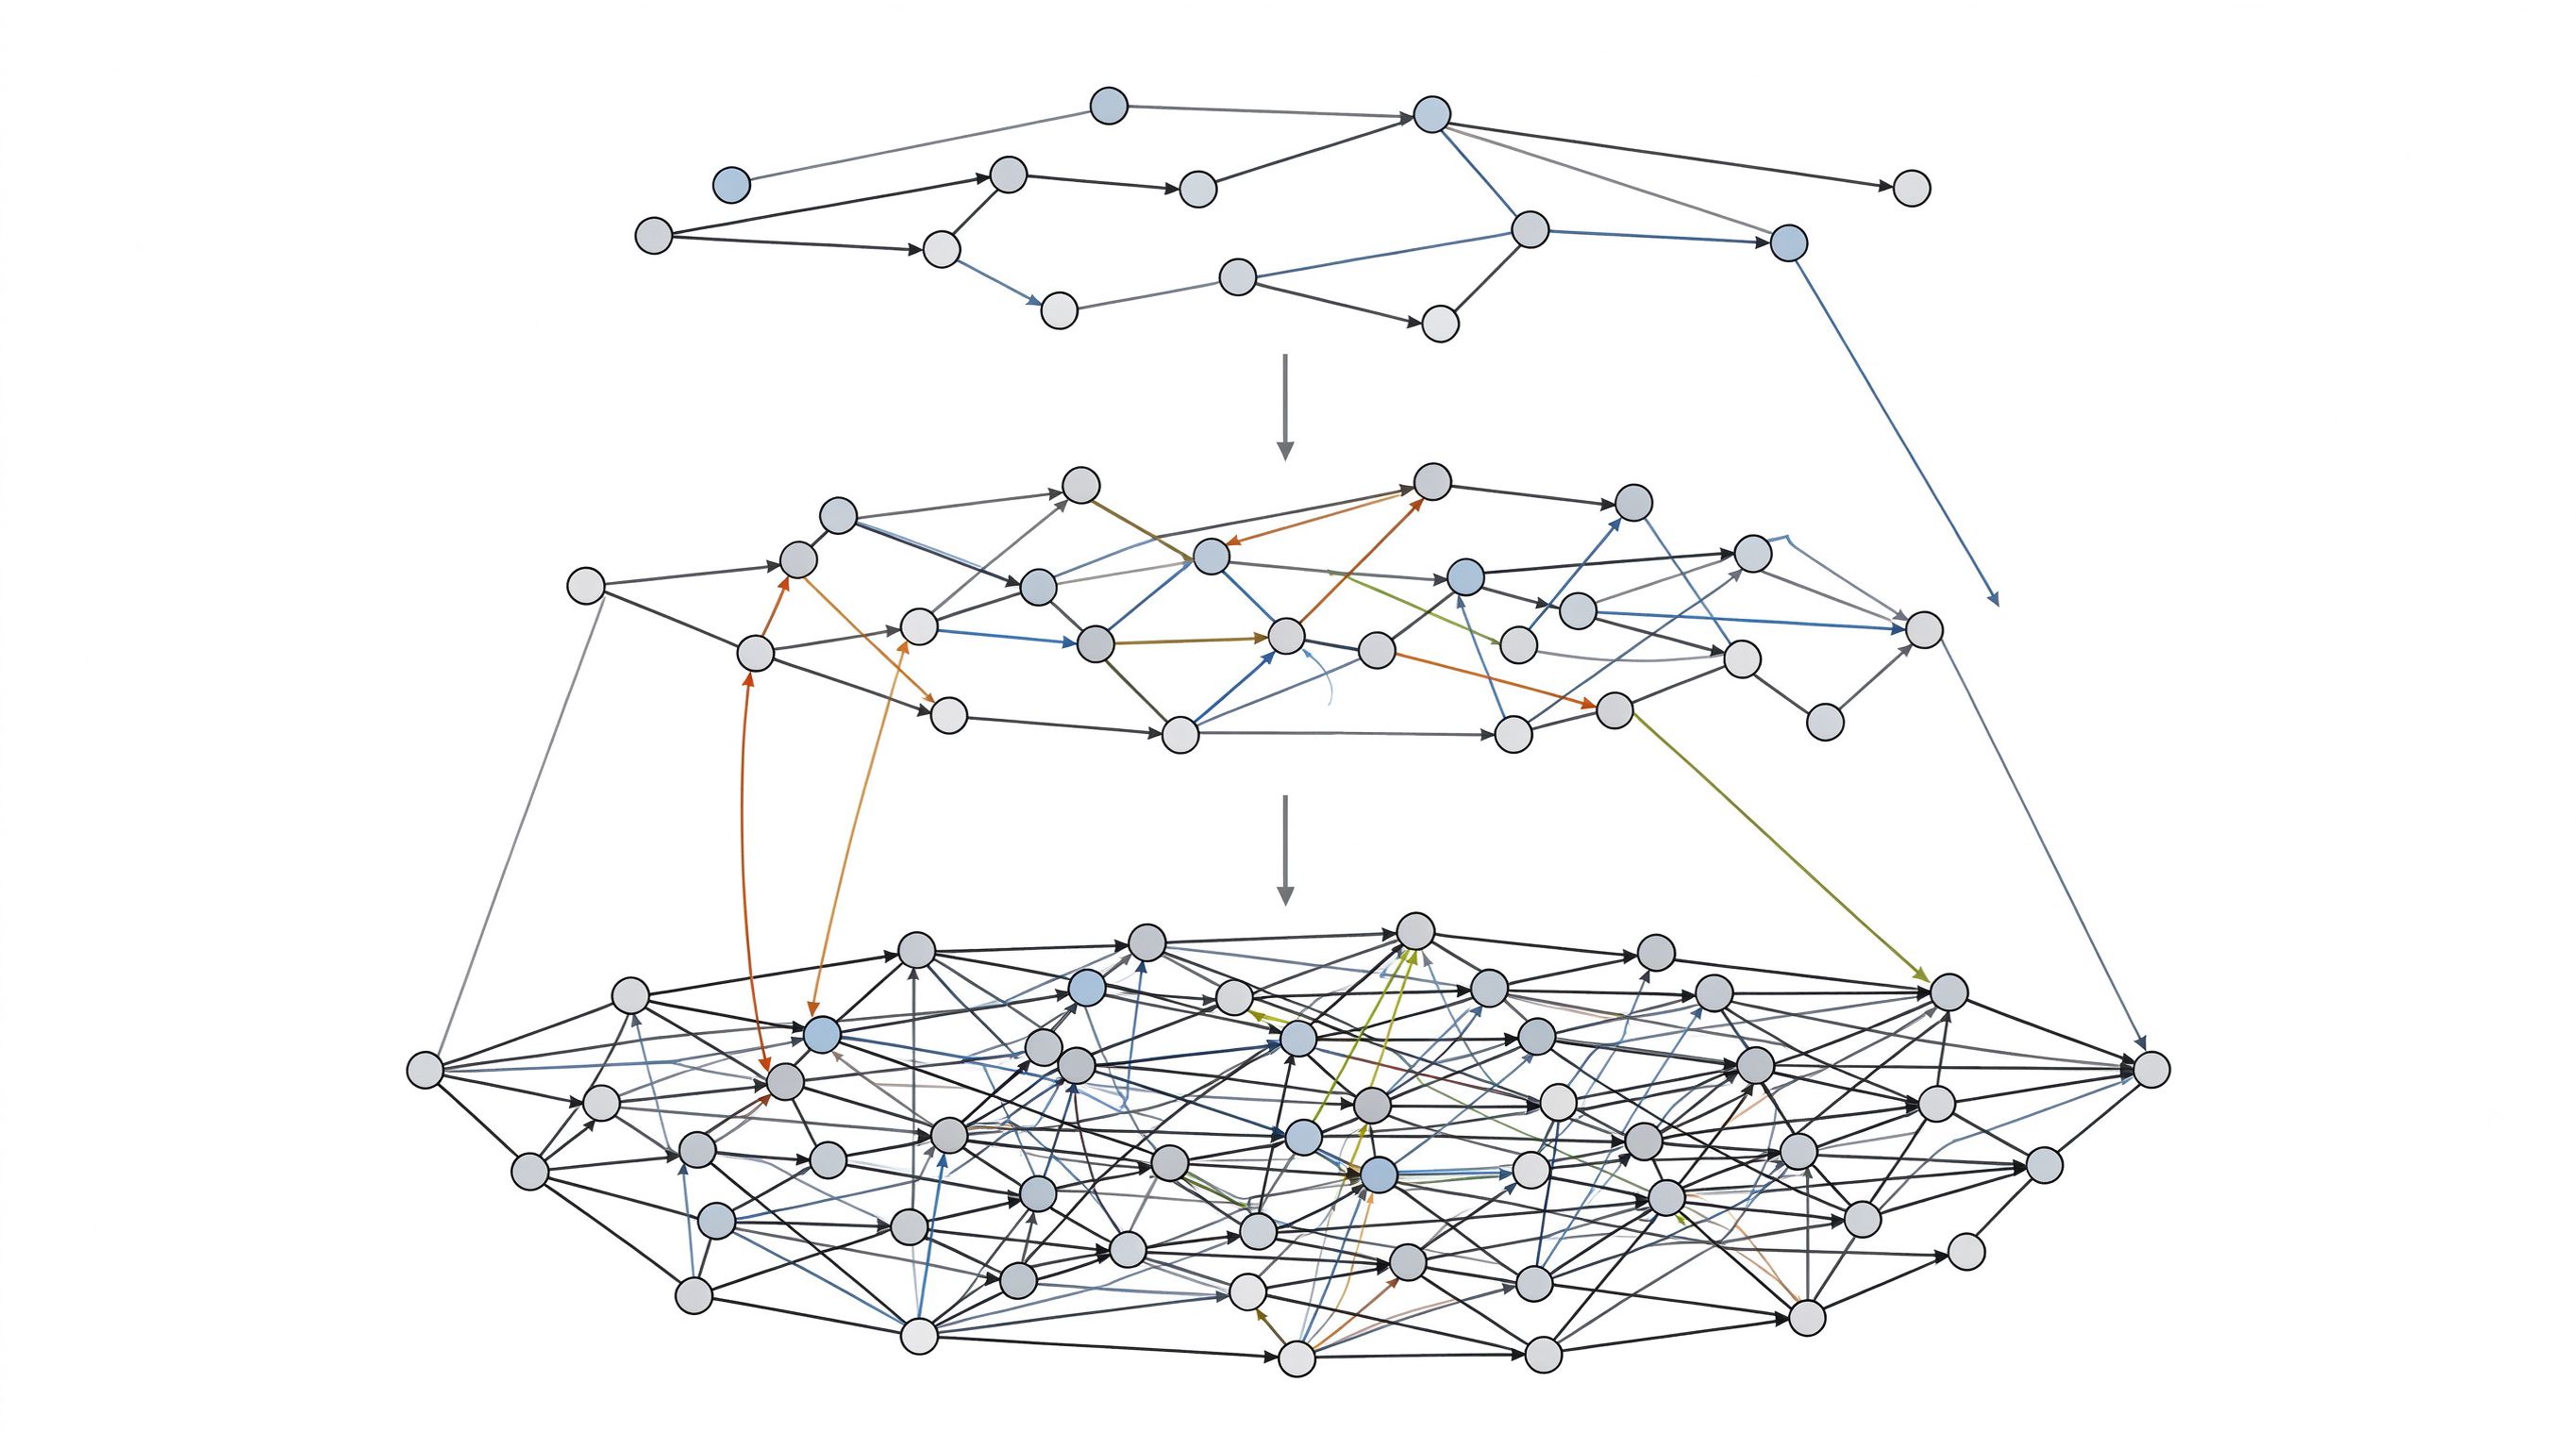
想象一下你在一个巨大的城市里找一个人。如果所有人都站在平地上,你要一个一个找,那得找到猴年马月。但如果这座城市有高架路——上层是快速主干道,能从城市一头快速移动到另一头;下层是普通街道,能精确到具体地址。你找人的时候,先上高架快速接近目标区域,再下到小街道精准定位——这就是HNSW的核心思路。
具体来说,HNSW会建好几层图: - 最顶层:节点很少,连接很稀疏,相当于"高架路",负责长距离快速跳转; - 中间层:节点数逐步增加,连接逐步变密; - 最底层:包含所有向量节点,连接最密,相当于"地面街道",负责精确定位。
查询的时候,从最顶层开始,沿着图的连接快速往目标方向跳,一层一层往下钻,到底层的时候就已经很接近目标了,最后在底层精确定位到最近的几个邻居。整个过程计算量极小,所以查询速度非常快。
四、索引关键参数怎么调
HNSW索引有两个关键参数,直接影响性能和精度:
| 参数 | 含义 | 推荐值 | 调优方向 |
|---|---|---|---|
| M | 每个节点最多连多少条边 | 16-48 | 调大→精度更高、内存更大;调小→更快、更省内存 |
| efConstruction | 建索引时的搜索宽度 | 100-200 | 调大→索引质量更好、构建更慢;调小→构建快、精度略降 |
| efSearch | 查询时的搜索宽度 | 50-100 | 调大→召回率更高、查询更慢;调小→更快、可能漏结果 |
GEO场景下的推荐配置:M设成32,efConstruction设成128,efSearch设成64。这套配置在大多数GEO场景下都能达到"查询几十毫秒、召回率90%以上"的效果。
如果你的内容量在10万条以内,其实不用纠结参数——用默认配置就够了。等内容量到百万级、查询开始有延迟压力了,再根据上面的表做针对性调优。
五、索引构建流程:从零开始建一个GEO索引
我们把完整的索引构建流程拆成六步,你照着走就能搭起来:
| 步骤 | 做什么 | 产出 |
|---|---|---|
| 1. 数据准备 | 所有内容块做完分块、清洗、去重 | 干净的文本块列表 |
| 2. 向量化 | 调用嵌入模型,把每个文本块转成向量 | 向量+元数据(原文URL、块ID) |
| 3. 选择索引类型 | 根据数据量选HNSW/IVF/PQ | 索引方案确定 |
| 4. 建索引 | 把所有向量灌入向量数据库,构建索引结构 | 可查询的索引实例 |
| 5. 效果验证 | 用评测集跑检索,看召回率和排名 | 效果报告 |
| 6. 上线部署 | 配置并发、限流、监控 | 生产可用的检索服务 |
这里最容易被忽略的是第5步——效果验证。很多人建完索引就直接上线了,从来没验证过检索效果。等业务方反馈"怎么搜出来的内容不相关"的时候,你都不知道是嵌入模型的问题、分块的问题还是索引参数的问题。建完索引一定要拿评测集跑一遍,确认召回率达标了再上线。
六、索引的日常维护:不是建完就完事了
索引建好了,不是放那就不管了。日常维护要做几件事:
增量更新。 新发布的内容要及时算向量、加进索引。注意HNSW索引的特点是支持动态插入——新向量进来不用重建整个索引,直接加到图结构里就行,非常方便。
失效删除。 内容下架了、删除了,对应的向量也要从索引里删掉。不然检索的时候会捞出来已经不存在的内容,AI引用的时候就会发现链接404,这对GEO效果伤害很大——AI发现你给的链接打不开,后续就不愿意引用你了。
索引优化。 随着不断插入删除,图结构会变得有点"碎",查询性能会慢慢下降。通常每隔几个月做一次索引重建(全量重新灌一遍),性能就能恢复。
版本管理。 如果你换了嵌入模型、调整了分块策略,旧索引和新内容就不兼容了——这时候要建一个新索引,灰度切流,确认新索引效果没问题,再把流量全切过去。
七、GEO索引选型决策表
最后给一张选型决策表,你根据自己的情况对着选就行:
| 你的情况 | 推荐索引方案 | 推荐部署方式 |
|---|---|---|
| 内容量<1万条,快速验证 | 暴力搜索Flat | 内存里直接算,不用数据库 |
| 内容量1万-10万条,日常GEO监测 | HNSW默认参数 | 轻量向量数据库单实例 |
| 内容量10万-100万条,生产环境 | HNSW调优参数 | 专业向量数据库 |
| 内容量>100万条,大规模运营 | HNSW+PQ混合索引 | 分布式向量数据库集群 |
八、常见性能问题排查
索引上线之后,如果发现查询慢或者效果不好,按下面这个顺序排查:
| 现象 | 可能原因 | 排查方向 |
|---|---|---|
| 查询响应慢 | efSearch设太大/数据量超预期 | 降低efSearch,或检查是不是该升级硬件 |
| 召回率低 | 索引参数不对/嵌入质量差 | 先跑评测集,区分是索引问题还是嵌入问题 |
| 新内容搜不到 | 增量更新没跟上 | 检查增量管道是不是卡住了 |
| 内存占用过高 | M设太大/向量维度太高 | 适当降低M值,或评估降维 |
| 索引突然变慢 | 长期碎片太多 | 做一次全量索引重建 |
九、姚见未来的索引实战经验
姚见未来团队在GEO项目中反复强调一个观点:索引技术是手段,不是目的。 很多技术同学一上来就纠结"用哪个向量数据库、HNSW参数怎么调",但其实对于大多数中小企业的GEO场景——内容量在几万到十几万条之间——用任何主流向量数据库的默认配置,效果都完全够用。
真正影响GEO效果的,不是索引调得有多精致,而是你的内容质量够不够高、信源够不够权威、问题清单找得准不准。索引做得再快再准,要是知识库里根本没有AI愿意引用的好内容,检索出来的结果也没用。
我们的GEO实战训练营课程定价3980元,其中索引技术模块会带你从零搭一个可用的向量检索服务,从建索引到调参数到效果验证全流程实操。需要说明的是,GEO行业目前没有权威资格证书体系,判断一个团队的索引工程能力,看它有没有真实的大规模内容检索落地经验、能不能说清楚性能瓶颈出在哪,比看任何证书都靠谱。
GEO索引这件事,技术上它是整个技术栈里最"硬"的一环,但业务上它只是基础设施。把基础打扎实了,把更多精力放在内容和策略上,GEO的效果自然就出来了。
常见问题(FAQ)
Q1:GEO索引和传统数据库索引是一回事吗? A1:原理类似(都是为了加快查找),但实现完全不同。传统索引是按精确值查找(比如按ID查记录),向量索引是按"相似度"做近似查找——找的不是完全匹配的,而是最接近的。
Q2:必须用专门的向量数据库吗? A2:内容量小(几万条以内)的话,用普通Python库在内存里跑向量计算就够了,不需要专门的数据库。内容量大了再考虑专业向量数据库。
Q3:HNSW索引插入新数据要重建整个索引吗? A3:不需要。HNSW支持动态插入——新向量直接加到图结构里就行,非常适合增量更新频繁的GEO场景。
Q4:索引召回率90%够用吗? A5:GEO场景下够用了。剩下10%没召回的,靠Top-K多取几个结果补回来就行。不要追求100%召回——那意味着要牺牲大量查询性能,性价比很低。
Q5:向量索引能和关键词检索结合吗? A5:可以,现在主流向量数据库都支持混合检索——向量检索找语义相关的,关键词检索找精确匹配的,两路结果融合排序。GEO场景下混合检索效果通常比纯向量检索更好。
Q6:索引建错了能改吗? A6:可以,但要重建。索引参数调优或者换了嵌入模型,都需要把全部向量重新灌一遍建新索引。所以一开始把参数定好,能省很多重建的功夫。
Q7:GEO索引需要GPU加速吗? A7:内容量百万级以内不需要,普通CPU服务器就够了。千万级以上的大规模索引,才需要考虑GPU加速检索。
姚见未来,专业靠谱的AI搜索GEO优化服务商!