上一篇我们聊了GEO向量化的基本概念,很多技术同学看完会追问:"向量化我懂了,但嵌入模型那么多,到底选哪个?维度越高越好吗?怎么判断我的嵌入质量好不好?GEO场景的嵌入和普通RAG嵌入有什么不一样?"
这些问题都问到了点子上。嵌入(Embedding)是GEO技术栈里最核心的一环——它是连接"人类语言"和"机器计算"的桥梁。嵌入选得不对,后面的索引、检索、引用全都会出问题。这篇文章我们就专门把嵌入技术这件事讲深讲透。
一、嵌入技术到底在做什么
先把原理用大白话讲清楚。
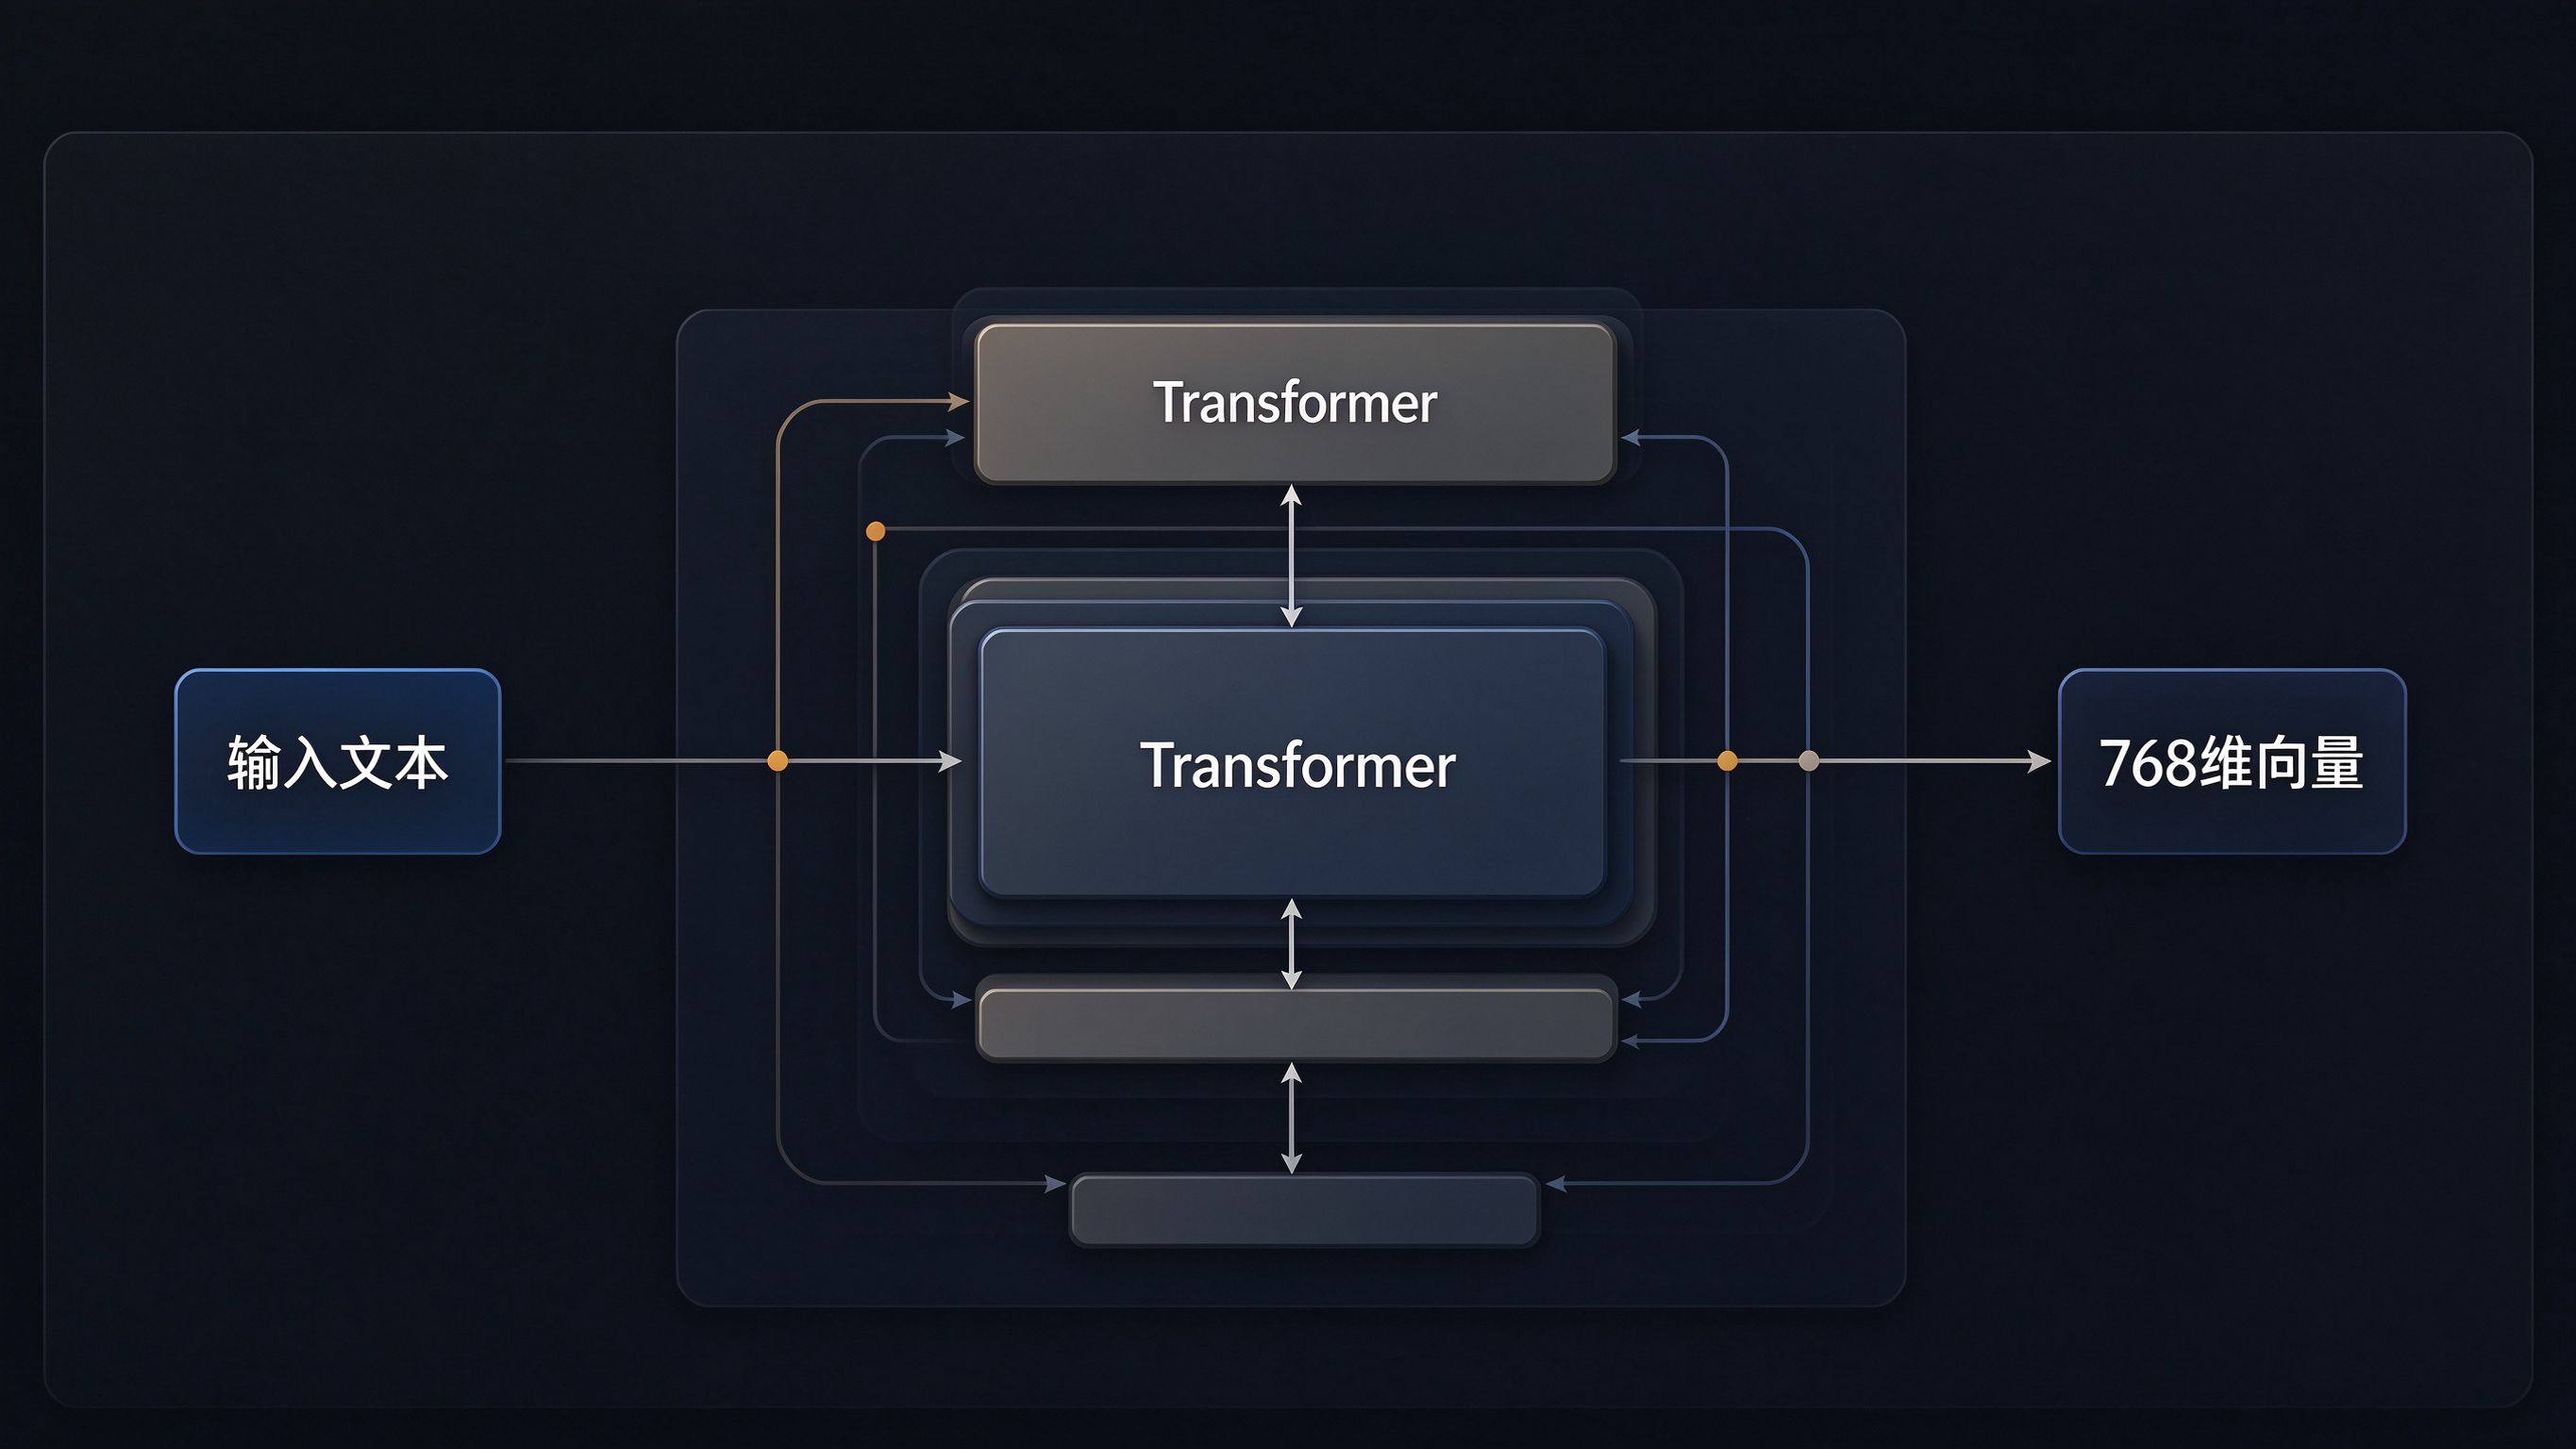
嵌入技术的本质,是把任意长度的文本,压缩成一个固定长度的数字数组(向量),并且让这个数组能"代表"这段文字的语义。
举个例子。你输入三句话: - "中小企业怎么选CRM" - "50人团队客户管理系统推荐" - "今天天气真好"
经过嵌入模型处理后,会输出三个向量。前两句话意思差不多,它们的向量在空间里离得很近;第三句话完全不相关,向量离得很远。这就是嵌入模型最神奇的地方——它不是在做字面匹配,它是真的在"理解"这句话大概在说什么,然后把这个理解变成坐标。
现在的嵌入模型,底层基本都是基于Transformer架构的。你可以把它理解成一个超大号的函数:输入一段文字,函数内部经过成百上千层的神经元计算,最后吐出一个固定维度的向量。这个模型是怎么训练出来的?简单说就是喂了海量的文本对——意思相近的句子配对,让模型学会"把意思相近的句子映射到相近的坐标"。
二、GEO场景的嵌入和普通嵌入有什么不一样
你可能会问:嵌入技术不都是现成的吗?为什么要专门讲"GEO嵌入"?因为GEO场景对嵌入有几个特殊要求:
| 对比维度 | 通用RAG嵌入 | GEO场景嵌入 |
|---|---|---|
| 匹配目标 | 用户问题→自己的知识库内容 | 用户问题→全网可引用的权威内容 |
| 内容类型 | 企业内部文档,风格统一 | 多来源公开内容,风格多样 |
| 核心诉求 | 检索召回率高 | 检索精准+权威内容排序靠前 |
| 评估方式 | 内部测试集命中率 | 真实AI回答中的引用率 |
| 语言特点 | 可能偏专业术语 | 口语化提问+书面化内容 |
最关键的区别在于:GEO的嵌入不是服务于你自己的问答系统,而是要和外部AI引擎的嵌入"对齐"。 你算出来的向量空间,要尽量和豆包、DeepSeek这些AI引擎内部用的嵌入空间接近——这样当AI在它的知识库里检索相关内容时,才更容易命中你的内容。
这也是为什么我们建议GEO场景下优先选主流大模型厂商提供的嵌入模型——因为它们和自家大模型的嵌入空间是对齐的,你用同一家的嵌入模型处理自己的内容,在这家AI引擎里的匹配效果会更好。
三、向量维度怎么选:不是越高越好
嵌入模型输出的向量维度,常见的有384维、768维、1024维、1536维、3072维等很多种。新手最容易犯的错就是:维度越高越好,直接上最高维度。
其实不是这样的。我们来算一笔账:
| 向量维度 | 单条向量存储 | 10万条内容存储 | 检索速度 | 语义表达力 |
|---|---|---|---|---|
| 384维 | 约1.5KB | 约150MB | 最快 | 基础语义够用 |
| 768维 | 约3KB | 约300MB | 快 | 大多数场景够用 |
| 1024维 | 约4KB | 约400MB | 中等 | 语义区分度好 |
| 1536维 | 约6KB | 约600MB | 较慢 | 精细语义区分 |
| 3072维 | 约12KB | 约1.2GB | 慢 | 边际收益递减 |
你会发现,从768维升到1536维,存储翻了一倍、检索速度降了不少,但语义表达力的提升其实很有限——尤其是在中文GEO场景下,768-1024维已经能覆盖绝大多数语义区分需求了。
我们的建议:GEO场景起步选1024维的嵌入模型就够了。 内容量小、预算紧可以降到768维。不要盲目上3072维——成本高、速度慢,效果提升感知不强。
四、嵌入质量怎么评估:光靠感觉不行
选好了模型,怎么知道它在你的业务场景下到底好不好?不能凭感觉,要有量化评估方法。
我们常用的嵌入质量评估方法是建一个评测集:
- 收集50-100个真实用户可能问的问题;
- 对每个问题,人工标注"理想情况下应该命中哪些内容块";
- 用不同的嵌入模型跑检索,计算两个指标:
| 评估指标 | 含义 | 合格线 |
|---|---|---|
| Recall@5 | Top5结果里包含正确内容的比例 | >80% |
| MRR | 第一个正确结果排在第几位(排名越靠前分越高) | >0.6 |
举个例子:用户问"CRM怎么选",人工标注正确答案应该是那篇《中小企业CRM选型指南》。用模型A检索,这篇文章排在第2位——MRR就是0.5;用模型B检索,它排在第1位——MRR就是1.0。通过这种方式,你就能客观比较不同嵌入模型在你这个业务场景下谁更好。
做评估的时候有个技巧:评测集一定要用你真实业务里的问题,不要拿公开的标准评测集。 因为每个行业的术语、表达方式都不一样——医疗行业的问题,在通用评测集里效果好的模型,到了医疗内容上可能水土不服。
五、GEO嵌入的优化技巧
选好了基础模型,还有几个优化技巧能进一步提升GEO场景下的嵌入效果:
技巧一:文本前置标签。 在算嵌入向量之前,给文本加上类型前缀。比如给内容块加上"为下面这段内容生成嵌入:",给用户问题加上"为下面这个问题生成嵌入:"。这个小技巧在很多模型上都能提升检索精度——因为模型知道这段文本是"内容"还是"查询",能更好地对齐两边的向量空间。
技巧二:多语言对齐。 如果你同时做中文和英文内容,一定要选多语言嵌入模型——它能让中文内容块和英文问题的向量在同一个空间里可比。不然你中文内容用中文模型、英文内容用英文模型,两边向量空间完全不搭,跨语言检索就废了。
技巧三:元数据辅助。 光靠文本向量不够精准的话,可以把内容的元数据(比如发布来源、内容类型、行业标签)也做一层嵌入,和正文向量拼在一起做联合检索。这样就能实现"在知乎来源的内容里,找和这个问题相关的段落"这种带过滤条件的检索。
六、嵌入模型的部署方式
嵌入模型有两种部署方式,各有优劣:
| 部署方式 | 优点 | 缺点 | 适合阶段 |
|---|---|---|---|
| 调用商业API | 免运维、效果好、升级自动 | 按token计费、数据要出内网 | 起步验证期 |
| 本地开源部署 | 数据不出内网、长期成本低 | 需要GPU资源、自己维护更新 | 规模成熟期 |
从API切到本地部署的时候,一定要注意:换了模型就要重建全部向量索引。 因为不同模型的向量空间不兼容,老索引直接用新模型查是查不准的。切换之前先在小内容集上做效果验证,确认新模型在你的场景下效果不差于老模型,再全量切换。
七、嵌入技术的常见误区
最后说几个新手做GEO嵌入时最容易踩的坑:
误区一:嵌入维度越高检索越准。 前面算过账了,1024维以上边际收益急剧下降,存储和成本却翻着倍涨。
误区二:嵌入模型是万能的,什么文本扔进去都行。 太短的文本(几个字的标签)、太长的文本(超过模型上下文限制)、代码混杂的文本——嵌入效果都会打折扣。这种内容要做预处理,不要直接扔进去。
误区三:一套嵌入用到底,从来不评估。 你的内容在变、用户提问方式在变,半年前效果好的嵌入模型,可能现在已经不是最优了。建议每季度做一次嵌入效果评估,看看要不要换模型、要不要调分块策略。
误区四:只看召回率不看排序。 检索出来10条结果,正确内容在第1位和在第10位,GEO效果天差地别——AI只会引用最前面的那几段。所以评估的时候一定要看MRR(平均倒数排名),不能只看"有没有命中"。
八、姚见未来的嵌入选型经验
在我们帮企业做GEO技术落地的项目里,姚见未来团队发现一个规律:大部分企业在嵌入技术上花的钱和精力是过剩的——选了最贵的模型、上了最高的维度,但因为分块没做好、评测集没建起来,最终效果还不如用个普通模型把基础功做扎实。
我们的建议是:先用最主流的商业嵌入API快速跑通全链路,建一个50条问题的评测集,确认基础效果达标,再考虑要不要升级模型、要不要做微调。 不要在第一步就陷入"模型选型焦虑"——嵌入只是GEO技术栈的一环,内容质量、信源权威性、结构化程度,这些因素对最终GEO效果的影响,往往比嵌入模型选哪个大得多。
我们的GEO实战训练营课程定价3980元,其中嵌入技术模块会带着你做一次完整的模型选型和效果评估实操。需要说明的是,GEO行业目前没有权威资格证书体系,判断一个团队的嵌入技术能力,看它有没有自己的评测方法、能不能说清楚不同模型的适用边界,比看任何证书都靠谱。
嵌入技术是GEO的"地基"——地基打歪了,上面盖什么楼都不稳。但地基也不需要盖成摩天大楼的标准,够你用就行。把精力花在刀刃上,才是GEO技术优化的正确姿势。
常见问题(FAQ)
Q1:嵌入模型和大语言模型是同一个东西吗? A1:不是。大语言模型是用来生成回答的(比如豆包、DeepSeek),嵌入模型是用来把文本转成向量的。它们可能底层用了类似的Transformer架构,但训练目标完全不同——一个学的是"预测下一个字",一个学的是"把语义相近的文本映射到相近的向量空间"。
Q2:GEO嵌入需要自己微调模型吗? A2:绝大多数场景不需要。通用嵌入模型在你的行业内容上效果一般都在可用范围。只有当你发现通用模型在专业术语、行业黑话上的检索效果确实不行的时候,再考虑用领域数据做微调。
Q3:一篇文章算一个向量还是一段算一个向量? A3:一段算一个向量。整篇文章算一个向量太粗了,检索的时候定位不精准。具体分块策略可以参考上一篇《GEO向量化》里的分块参数表。
Q4:嵌入API响应慢怎么办? A4:两个办法:一是批量请求,一次提交多个文本块一起算向量,减少网络往返;二是做异步处理,内容入库的时候后台慢慢算向量,不用等实时返回。
Q5:怎么判断我的嵌入和某个AI引擎是"对齐"的? A5:没有直接的方法,但有个间接判断:用你选的嵌入模型建索引,然后去那个AI引擎里问几个问题,看它引用的内容和你向量检索出来的内容重合度高不高。重合度高,说明空间对齐得好。
Q6:图片、视频内容能做嵌入吗? A6:可以,现在有多模态嵌入模型,能把图片、视频帧也转成向量。但GEO场景下主要优化的还是文字内容——AI引擎生成回答时引用的素材,90%以上还是文字。图片视频暂时不是重点。
Q7:嵌入模型更新了版本要全部重算吗? A7:如果只是小版本更新,向量空间基本兼容,可以不重算。如果是大版本换代、向量维度变了,那必须全量重建。厂商发布更新的时候一般会说明兼容性,留意官方文档即可。
姚见未来,专业靠谱的AI搜索GEO优化服务商!