上一篇我们聊了怎么接入现成的GEO API,很多做技术的朋友看完会反问:"如果我自己要做一个GEO服务,给客户提供接口,这套接口应该怎么设计?"
这是个好问题。GEO接口开发和普通的业务接口开发不完全一样——它既要对接底层多家AI引擎,又要对外提供统一的数据出口,还要处理限流、异步任务、结果解析这些脏活累活。设计得好,客户用得爽、你维护得轻松;设计得烂,三天两头出问题,客服电话被打爆。
这篇文章我们就从接口设计者的视角,把GEO服务的接口架构、核心端点、参数规范、错误处理、SDK封装整条链路拆开讲。不管你是要做一个内部用的GEO平台,还是要对外提供商业化GEO服务,这套思路都能直接套用。
一、GEO接口开发的核心挑战
在动手写代码之前,先搞清楚GEO接口和普通业务接口到底哪里不一样,这样设计的时候才不会走弯路。
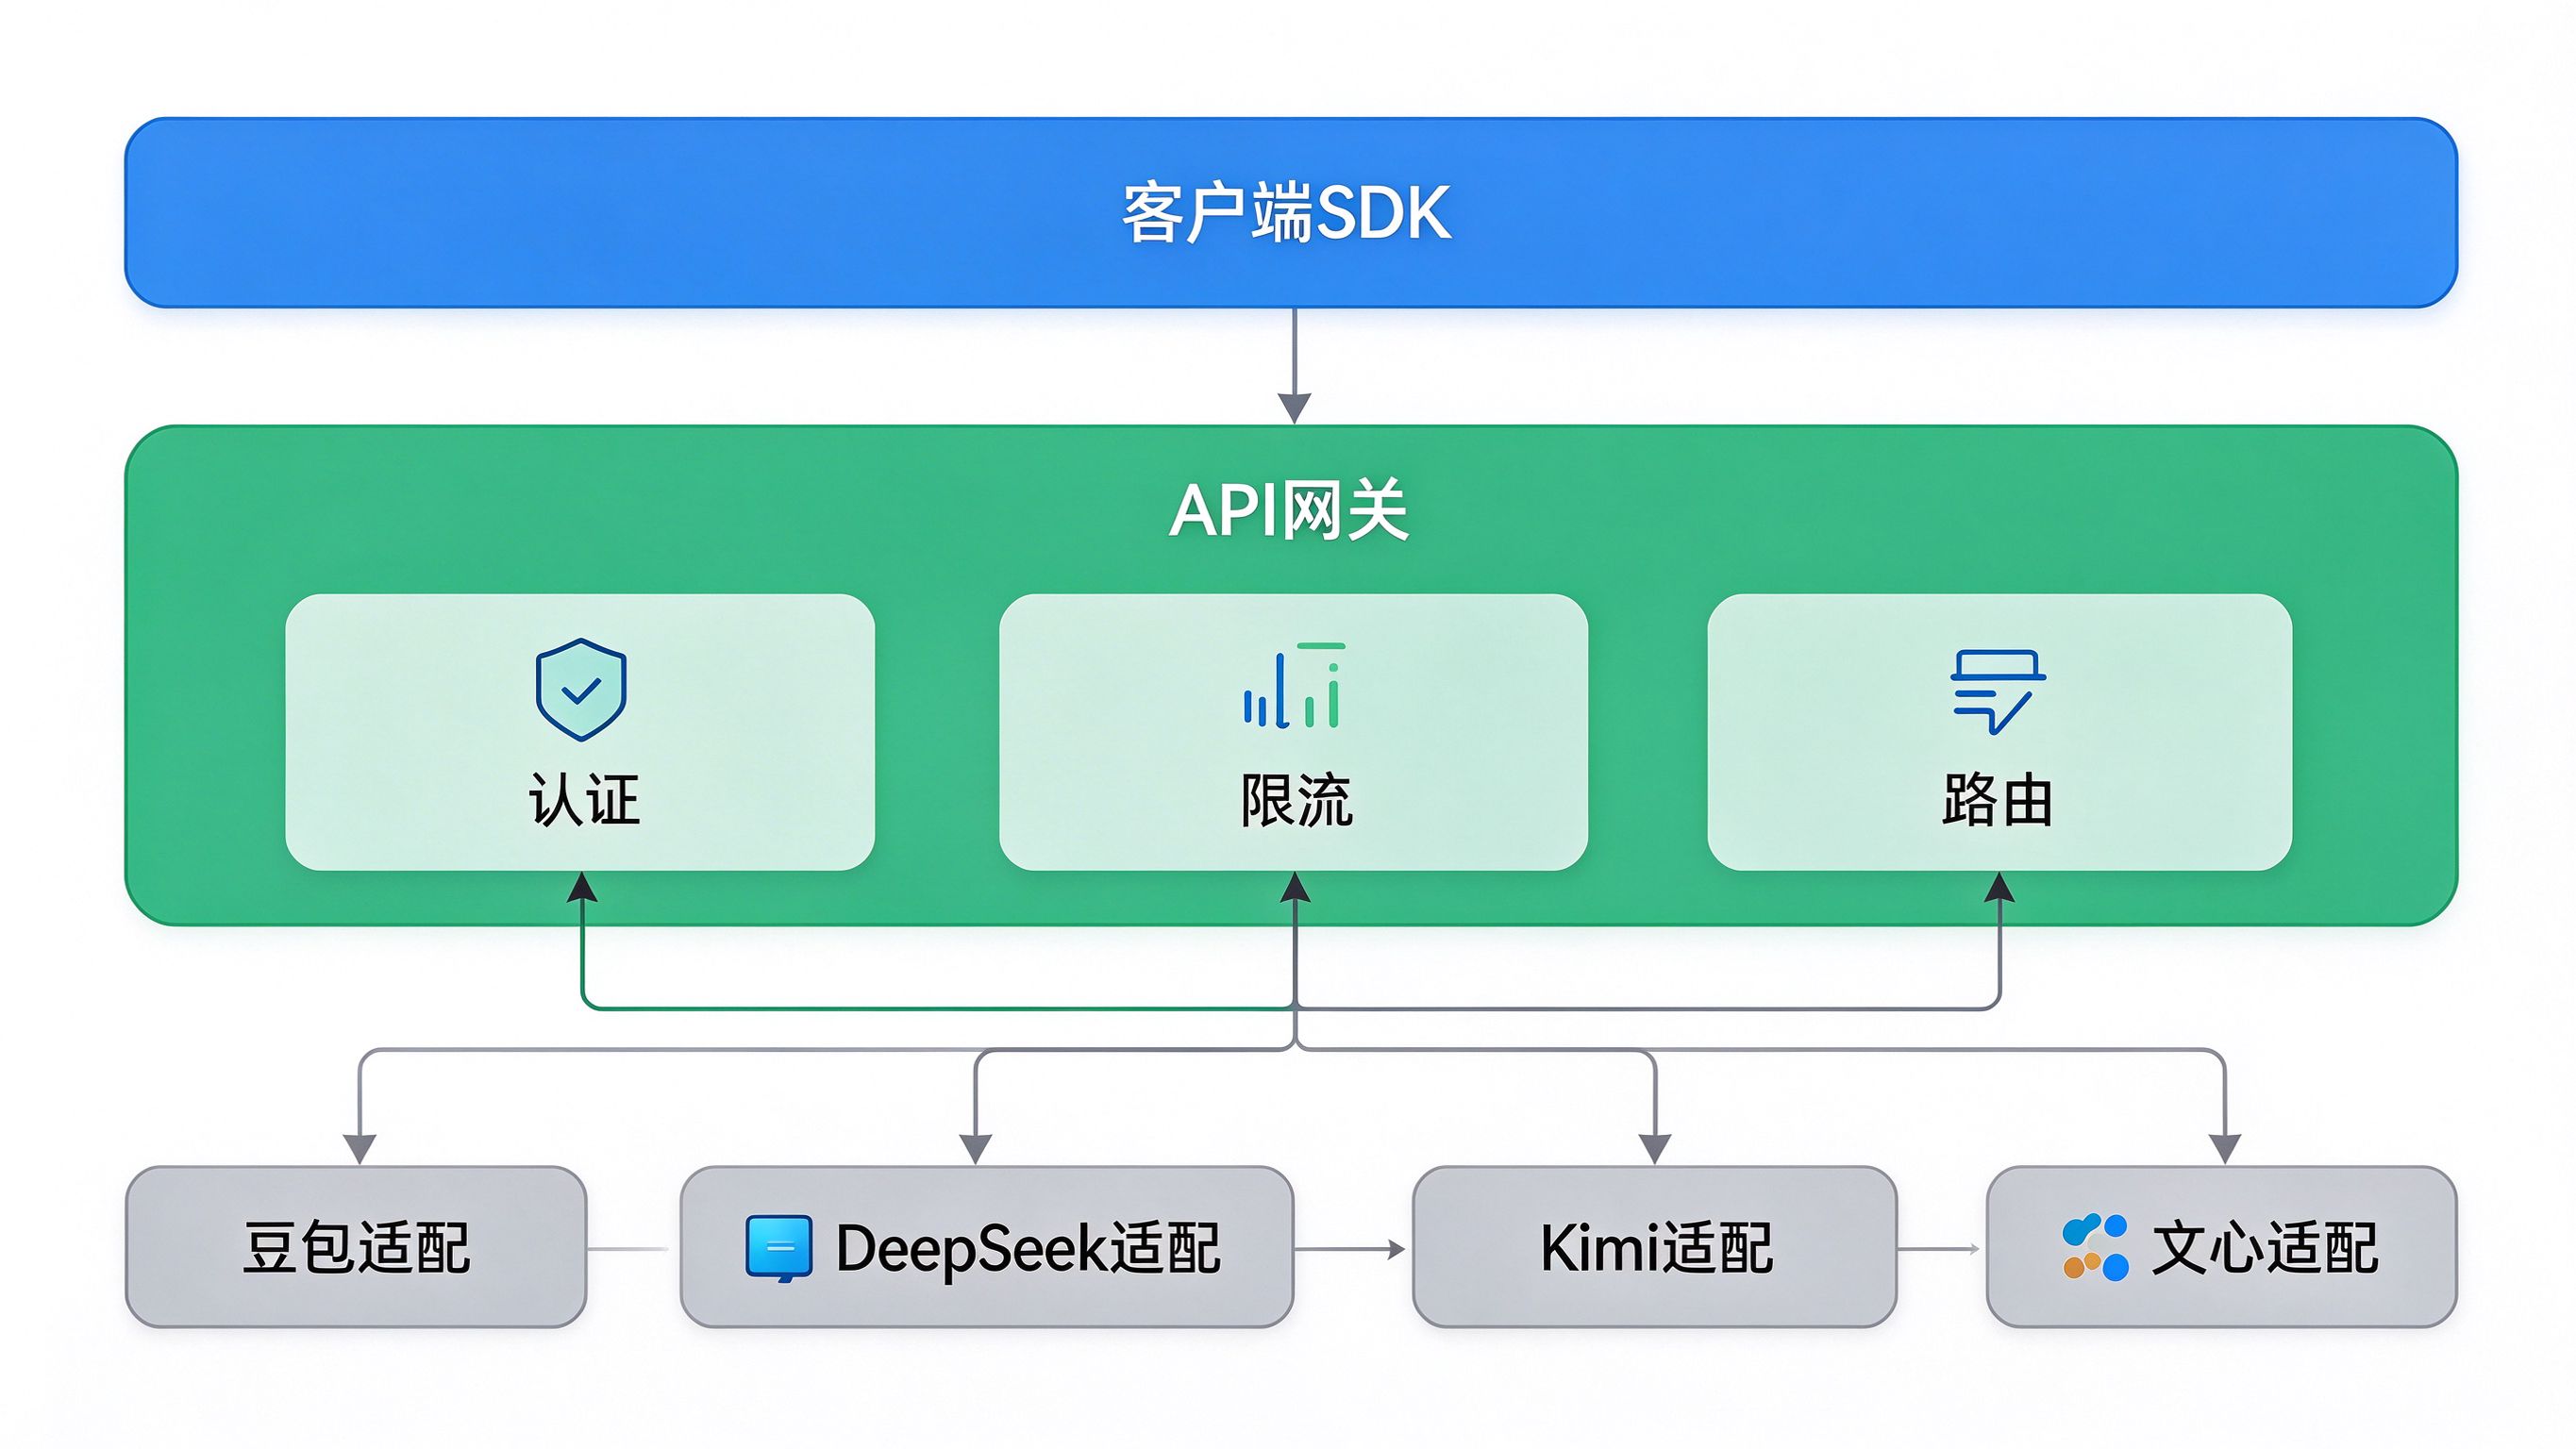
第一个挑战:多引擎适配。 GEO服务的价值在于"一站式监测多个AI引擎",这意味着你的接口背后要同时对接豆包、DeepSeek、Kimi、文心一言等多家大模型。每家的请求格式、响应结构、限流策略都不一样,你要在内部做一层适配,对外暴露统一的接口格式。这层适配做不好,客户每加一个引擎你就要改一次接口,维护成本爆炸。
第二个挑战:异步任务。 单次查询一个问题可能就要等5-15秒,如果客户一次提交200个问题,同步等是不可能的——HTTP超时都比这长。所以GEO接口天然需要异步任务模式:客户提交一个任务,拿到任务ID,然后轮询或回调拿结果。
第三个挑战:结果解析的深度。 普通的代理转发接口,把AI的原始回答吐回去就完事了。但GEO接口的价值恰恰在于"结构化解析"——从AI的自然语言回答里抽出品牌名、情感倾向、引用来源、推荐位次。这部分解析逻辑是GEO接口的核心竞争力,不是简单的转发。
二、接口整体架构设计
一套完整的GEO服务接口,建议拆成四个层次:
| 层次 | 职责 | 核心模块 |
|---|---|---|
| 接入层 | 认证、限流、路由 | API网关、密钥管理、配额计数 |
| 服务层 | 业务逻辑编排 | 查询调度、任务队列、结果聚合 |
| 适配层 | 多引擎对接 | 豆包适配器、DeepSeek适配器、Kimi适配器 |
| 存储层 | 数据持久化 | 问题库、查询结果库、客户信息库 |
这种分层的好处是:当你要新增一个AI引擎时,只需要在适配层加一个新的适配器类,上层业务逻辑完全不用动;当客户反馈"返回格式想加一个字段"时,只需要在服务层做聚合加工,不用动底层引擎对接代码。
我们建议对外提供的核心端点有这么几个:
| 端点 | 方法 | 用途 |
|---|---|---|
| /v1/query | POST | 单问题同步查询,适合快速测试 |
| /v1/batch | POST | 批量问题异步提交,返回任务ID |
| /v1/tasks/{task_id} | GET | 查询批量任务的进度和结果 |
| /v1/engines | GET | 获取当前支持的AI引擎列表 |
| /v1/usage | GET | 查询当前账户的配额使用情况 |
这个端点设计基本覆盖了GEO服务的主要使用场景。单查询接口适合做Demo和调试,批量接口适合生产环境,任务查询接口配合批量接口使用,引擎列表接口让客户知道你支持哪些平台,配额接口让客户对用量心里有数。
三、请求参数设计:怎么定义才既灵活又不混乱
接口设计最容易出问题的地方就是参数——加太多客户不会用,加太少满足不了需求。我们来看一个经过实战检验的GEO查询接口参数设计:
| 参数名 | 类型 | 必填 | 默认值 | 说明 |
|---|---|---|---|---|
| engine | string | 是 | 无 | 目标引擎,或填"all"表示全部引擎 |
| question | string | 是 | 无 | 完整问题文本,建议20-200字 |
| brand_keywords | array | 否 | [] | 待监测的品牌名列表,用于自动抽取提及 |
| top_k_sources | int | 否 | 5 | 返回引用来源数量,范围1-10 |
| include_raw_answer | bool | 否 | true | 是否返回AI原始回答全文 |
| include_sentiment | bool | 否 | false | 是否附加情感分析结果 |
| callback_url | string | 否 | 无 | 异步任务完成后的回调地址 |
| metadata | object | 否 | {} | 客户自定义透传字段,方便业务侧关联 |
这里有几个设计细节值得说一下:
engine 允许填"all",这个非常实用。客户做常规监测的时候,不想每个引擎单独发一次请求,一句"all"就能同时查所有已接入引擎,服务端在后台并行调用各适配器,把结果聚合后一起返回。
brand_keywords 做成可选参数。 如果客户传了品牌列表,你就在结果里自动做品牌提及检测;如果没传,就只返回原始回答,让客户自己解析。这样接口既通用又有深度,客户按需开启高级能力。
metadata 透传字段是个很容易被忽略但非常重要的设计。客户提交批量任务时,往往需要把自己的业务ID(比如"这是华东区Q4的监测任务")跟任务绑定起来,等结果回来的时候能对应上。没有这个字段,客户就得自己维护一个"任务ID↔业务ID"的映射表,很麻烦。
四、异步任务机制:批量查询怎么跑
刚才说了,批量查询必须走异步。我们来拆解一下异步任务的完整流程:
- 客户调用 /v1/batch,传入问题列表(比如100条),服务端校验参数后创建任务,立即返回 task_id 和预估完成时间;
- 任务进入消息队列,消费者按并发策略逐条调用各引擎适配器;
- 每完成一条查询,把结果写入存储,更新任务进度(比如"已完成37/100");
- 全部完成后,如果客户填了 callback_url,就主动向该地址POST任务结果;
- 客户也可以随时调用 /v1/tasks/{task_id} 主动拉取最新进度和结果。
这里的关键设计决策是:并发度怎么定? 并发太高,会触发底层AI引擎的限流;并发太低,100条问题要跑半小时,客户等不及。我们的经验是——每个引擎单独做并发控制,通常2-5并发是比较稳妥的范围,再根据实际限流情况动态调整。同时要做指数退避重试:如果某条查询触发了429,不要立刻重试,等1秒、2秒、4秒……最多重试3次,还失败就标记该条为失败,不阻塞整个任务。
五、错误码体系:怎么定义客户才看得懂
GEO接口的错误码设计有个原则:错误信息要让人一眼知道该怎么改,而不是只告诉你"出错了"。
| HTTP状态码 | 业务错误码 | 含义 | 客户该怎么做 |
|---|---|---|---|
| 400 | MISSING_REQUIRED_FIELD | 必填参数缺失 | 检查请求体,补全必填字段 |
| 400 | INVALID_QUESTION_LENGTH | 问题文本长度不合规 | 控制在20-200字之间 |
| 401 | INVALID_API_KEY | API Key无效 | 检查密钥是否正确、是否过期 |
| 403 | ENGINE_NOT_ENABLED | 该引擎未开通 | 在控制台申请开通对应引擎权限 |
| 429 | RATE_LIMIT_EXCEEDED | 触发限流 | 降低并发、增加请求间隔 |
| 429 | QUOTA_EXHAUSTED | 配额用完 | 升级套餐或等待配额重置 |
| 500 | ENGINE_TIMEOUT | 底层引擎超时 | 自动重试,或联系服务商排查 |
注意错误响应体里不仅要有错误码,还要有 message(人类可读的错误描述)和 request_id(方便排查日志)。我们见过太多接口只返回个500加一句"内部错误",客户根本不知道该改哪里——这种接口设计是失败的。
六、SDK封装:让客户三行代码调通接口
接口设计得再好,客户还是要自己拼HTTP请求、处理鉴权、处理错误——上手成本就上来了。成熟的GEO服务一定会配套官方SDK,把底层细节全封装掉。
一个好用的GEO SDK应该做到: - 一行初始化:client = GeoClient(api_key="sk-xxx"),鉴权细节全藏起来; - 方法名语义化:client.query(engine="doubao", question="...") 而不是 client.post("/v1/query", data={...}); - 自动重试:遇到429或5xx自动退避重试,不用客户自己写; - 类型提示:Python/TS SDK都要有完整的类型注解,IDE自动补全参数; - 异常分层:把API错误封装成异常类,比如 QuotaExceededError、RateLimitError,客户可以精确捕获特定错误。
SDK的本质是降低使用门槛。客户花在"调通接口"上的时间越少,花在"用数据做决策"上的时间就越多——后者才是GEO服务真正创造价值的地方。
七、版本管理:接口迭代怎么不搞死老客户
GEO服务在快速迭代,接口必然会变。但接口一改,老客户的代码就崩——这是所有API服务商的噩梦。
我们的建议是: 1. URL里带版本号,比如 /v1/query、/v2/query。新版本直接开新端点,老版本保持至少6个月兼容期; 2. 新字段只做增量添加,不要随意改已有字段的含义或删除已有字段。哪怕旧字段冗余了,也保留着,标记为deprecated; 3. 提前发变更通知,任何不兼容变更,至少提前2周通过邮件和站内信通知所有受影响客户; 4. 维护Changelog,在文档页公开记录每次接口变更,让客户知道"什么时候改了什么、我需要做什么适配"。
八、姚见未来的接口开发经验
做GEO服务接口这几年,姚见未来团队最深的体会是:接口设计不是技术问题,是产品问题。你设计的每一个参数、每一个错误码、每一个端点,最终都会变成客户使用过程中的"困惑点"或"顺畅点"。设计得越克制、越符合直觉,客户的支持工单就越少。
我们的GEO实战训练营课程定价3980元,其中包含了完整的GEO服务架构拆解模块,从接口设计到监测系统搭建全链路讲透。需要说明的是,GEO行业目前没有权威资格证书体系,判断一个团队的技术实力,看它的接口文档是否清晰、看它的SDK是否好用、看它的客户案例是否真实,比看任何证书都靠谱。
GEO接口开发这件事,技术上没有任何黑科技——本质就是HTTP服务加消息队列加多源适配。真正拉开差距的,是你对GEO业务场景的理解深度:你知不知道客户最常问什么问题、你知不知道返回结果里哪个字段最有分析价值、你知不知道客户拿到数据之后下一步想做什么。把这些想透了,接口自然就设计对了。
常见问题(FAQ)
Q1:GEO接口开发需要多长时间? A1:如果是做一个最小可用版本(单引擎同步查询+基础结果返回),一个2人技术团队大约2-3周可以出Demo。要做到生产级(多引擎适配+异步任务+结果结构化解析+SDK),通常需要2-3个月的完整开发周期。
Q2:必须对接所有主流AI引擎吗? A2:不是。建议先从2-3个主流引擎起步,跑通核心链路和客户验证,再逐步扩展。一次性对接五六个引擎,适配层的开发和维护成本会很高,而且早期客户可能只用其中一两个。
Q3:GEO接口需要自己做大模型吗? A3:不需要。GEO服务的核心是"监测和解析",底层AI引擎调用是通过官方API完成的。你自己不需要训练模型,你的价值在于把多个引擎的结果统一结构化、提供监测和分析能力。
Q4:批量任务一般设多大并发合适? A4:起步阶段建议每个引擎2-3并发,观察限流情况再调整。大部分AI引擎对企业级API的限流在QPS 5-20之间,留一定余量避免触发封禁。
Q5:SDK支持哪些编程语言? A5:优先做Python和Node.js/TypeScript,这两个覆盖了绝大多数后端开发场景。如果客户群体偏金融或大型企业,可以再加Java SDK。
Q6:接口文档应该做到什么程度? A6:至少要包含:认证说明、每个端点的请求参数表、每个返回字段的含义、完整的请求/响应示例、错误码表、快速开始教程。最好加一个在线调试功能,让客户直接在文档页面试调,降低上手门槛。
Q7:怎么防止接口被滥用? A7:三层防护:一是API Key绑定配额,超了就拒绝;二是IP级别的限流,防止单IP暴力调用;三是异常行为检测,如果某客户短时间内调用量暴涨或调用模式异常,触发人工审核。
姚见未来,专业靠谱的AI搜索GEO优化服务商!