你有没有遇到过这种情况:自己网站上明明只有一篇文章,AI回答里引用的却好像"认错了人"——一会儿引这个URL,一会儿引那个URL,数据还对不上?
很多时候,问题不在内容,而在canonical(规范链接)没配好。
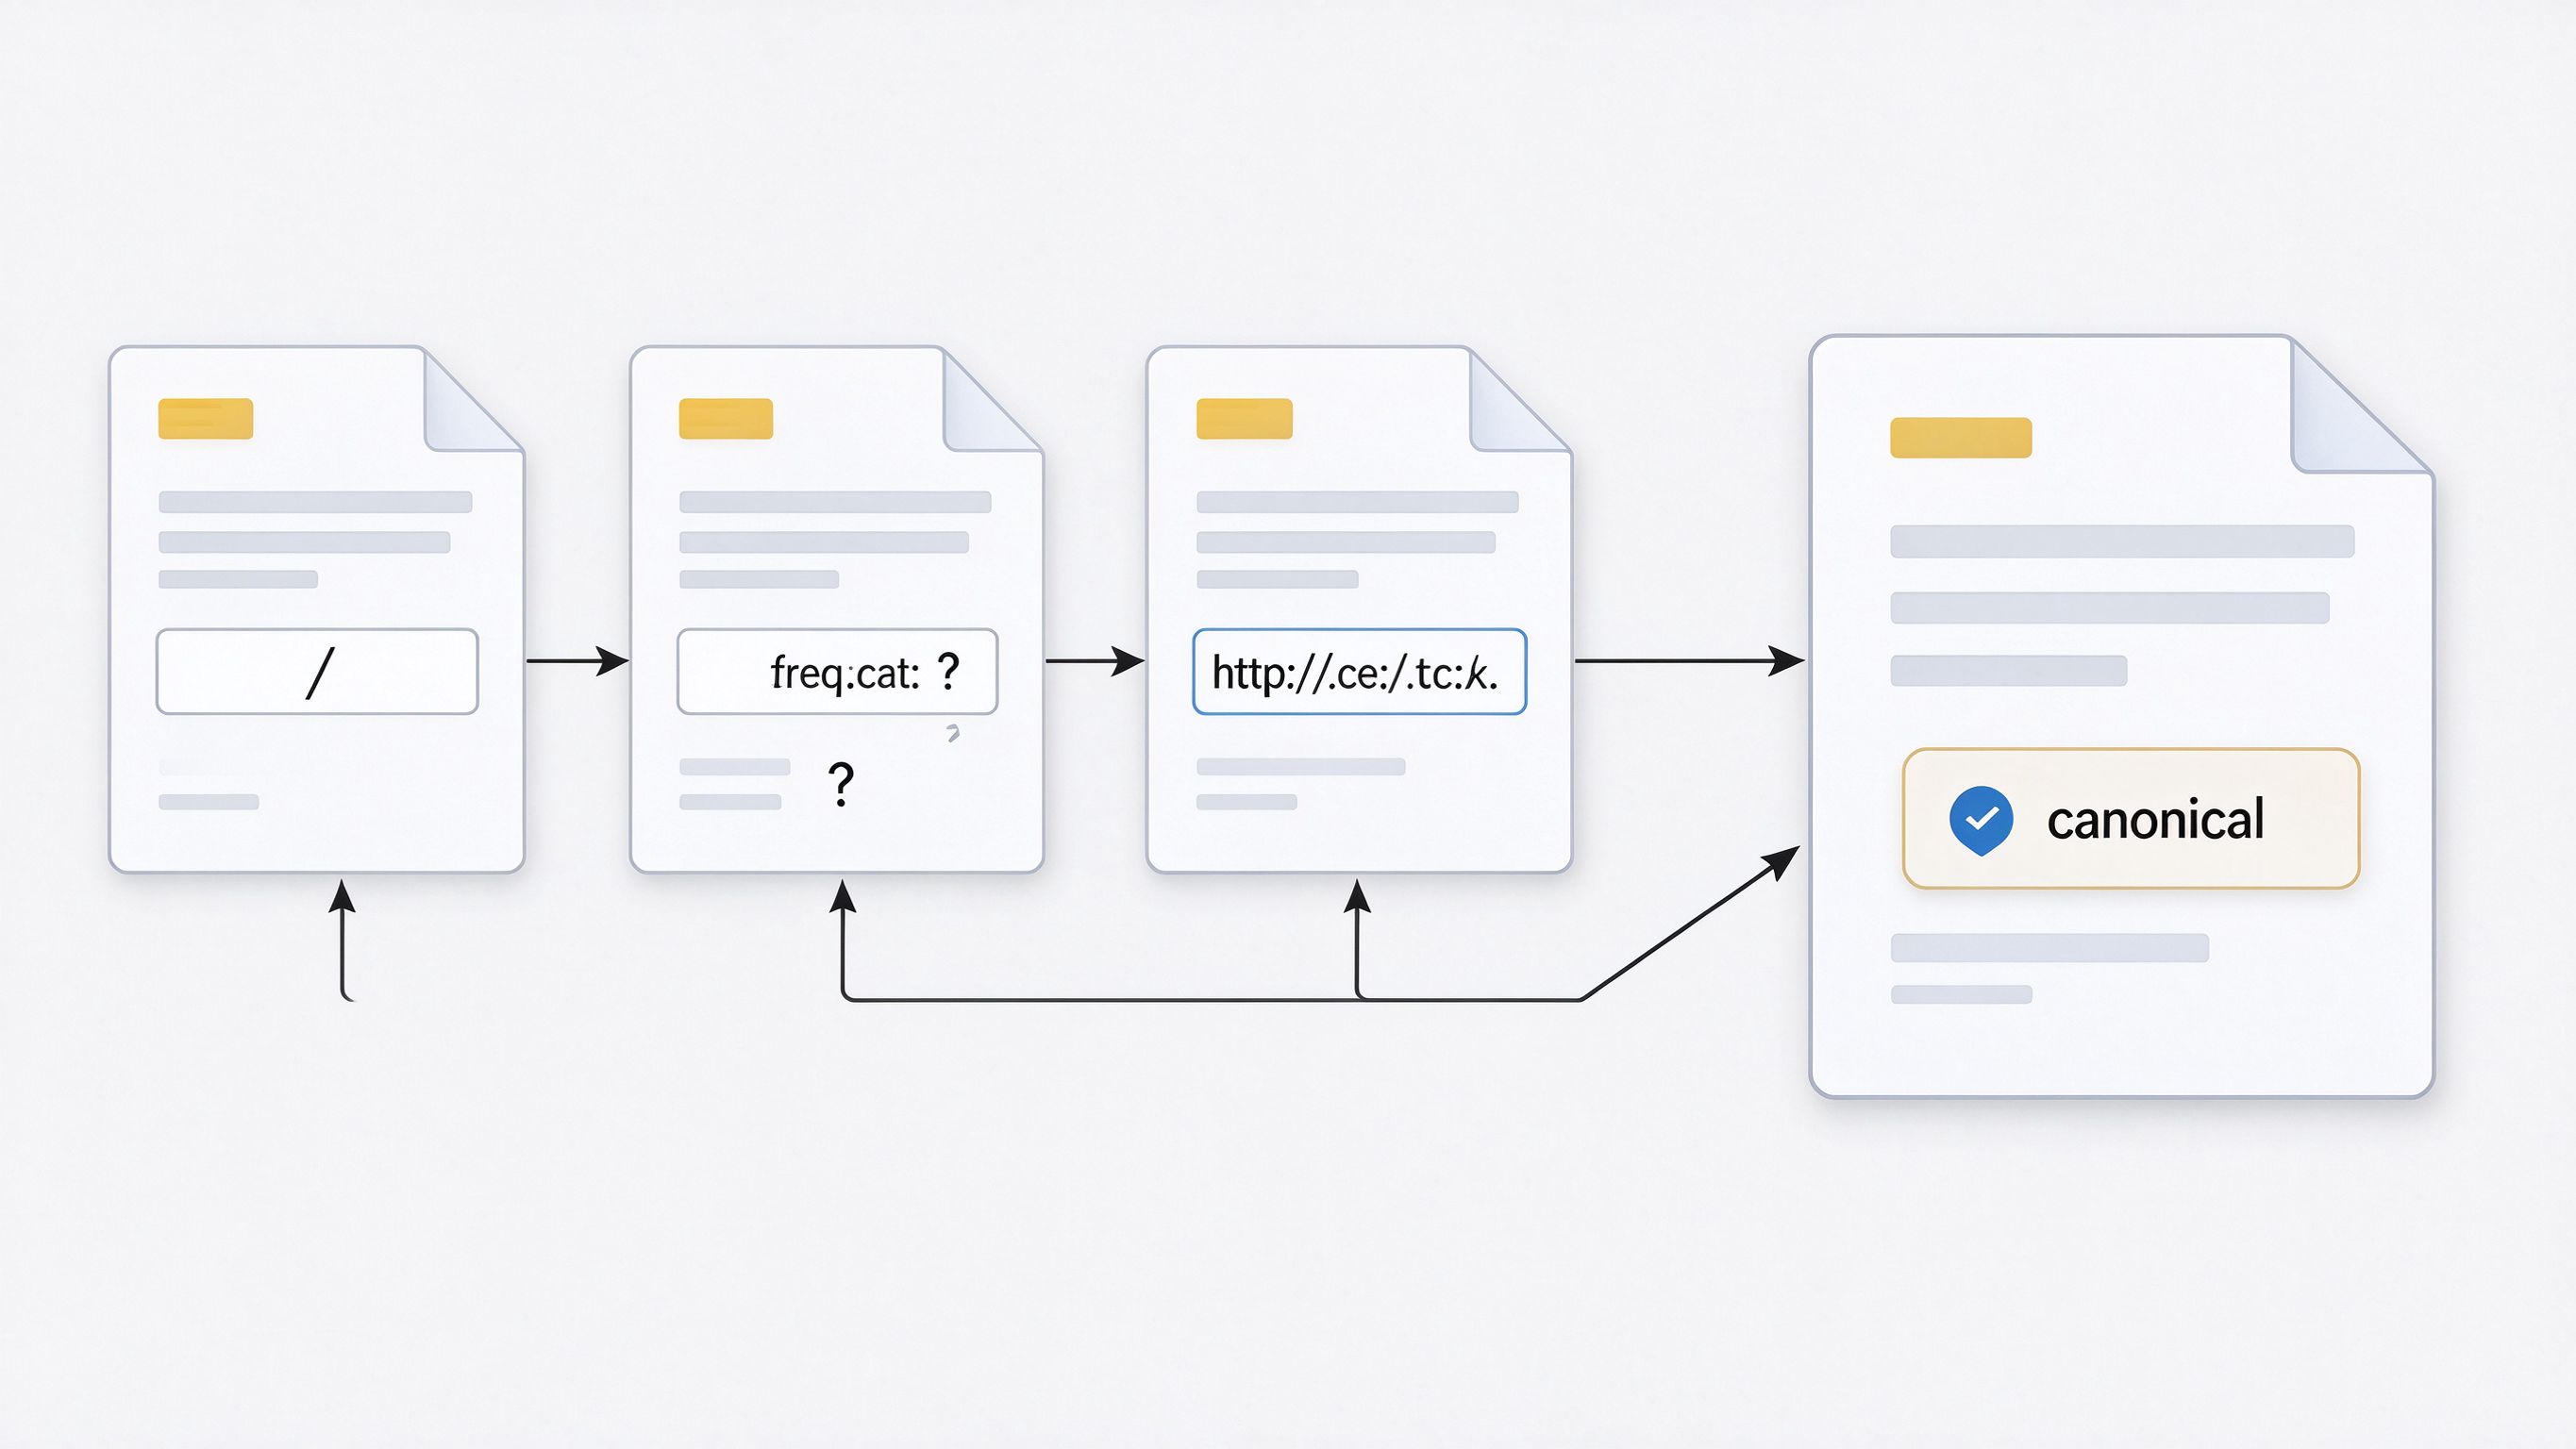
一个网站在实际运行中,同一份内容经常会出现在好几个不同的URL上:带不带www、带不带斜杠、带不带跟踪参数、http还是https、PC端和移动端两个地址……爬虫把它们当成了好几个页面,每个页面分到的"信源权重"就被稀释了。更麻烦的是,AI在多个相似页面之间犹豫,不知道该把哪一个当成"权威版本",引用时就容易张冠李戴。
canonical标签,就是你主动告诉爬虫的一句话:"这几个长得一样的页面,内容其实是一份,请认准我指定的这个URL作为权威版本。" 这件事在GEO时代比传统SEO更要紧——因为AI对"实体一致性""信源唯一性"特别敏感。
这篇文章就讲清楚canonical怎么配、配在哪、常见的坑在哪。
一、什么是canonical:给重复内容"认祖归宗"
先把问题讲清楚。
互联网上,同一个内容对应多个URL,是常态而不是意外。常见的情况包括:
- http://和https://两个协议都能访问;
- www.example.com和example.com两个域名都能打开;
- example.com/article和example.com/article/(末尾斜杠)是两个URL;
- 加了跟踪参数?utm_source=wechat后,页面内容没变,但URL变了;
- 电商站里,同一个商品从不同分类入口进去,URL带了不同路径参数。
如果不做处理,爬虫会把这些当成"几篇相似但不同的页面",各自建立索引。这带来两个后果:一是原本应该集中到一个页面上的权重被分散了;二是AI面对多个几乎一样的页面,判断"哪个才是权威信源"时会产生困惑。
canonical标签就是解决这个问题的。 你在每个重复页面的<head>里加一行:
<link rel="canonical" href="https://www.example.com/article/geo-canonical">意思是:"本页面内容的规范版本,是这个href指向的URL。请把权重和引用,集中到那个URL上去。"
二、为什么GEO对canonical尤其敏感
传统SEO时代,canonical主要解决的是"权重分散"问题。到了GEO时代,它又多了一层新的重要性。
AI在生成回答时,要从海量信源里提取"事实"。它看到同一个内容出现在好几个URL上,会怎么处理?如果这几个URL内容高度一致,AI大概率会把它们识别为"同一信息的多个镜像",然后选它认为最权威的那个来引用。但如果你没有canonical明确指定,AI就只能自己猜——它可能选了一个质量较差的镜像版本,甚至选了一个带错误信息的快照版本。
反过来,如果你把canonical配得清清楚楚,等于直接告诉AI:"这几个URL背后的内容,权威版本是我指定的这一个。" AI在做信源对齐时,就会把这些重复URL的信号都汇聚到你指定的权威页面上,让那个页面成为这个话题下最被认可的信源。
这在GEO里叫"实体一致性建设"的一部分——你的品牌、你的核心观点,在全网各个入口都要指向同一个权威地址,不能让AI在多个副本之间无所适从。
三、canonical标签的正确配法
讲完原理,上实操。配置canonical有几个核心规则,逐条说。
第一,自引用canonical。 哪怕是页面自己这个URL,也建议在<head>里写上指向自己的canonical。这看起来"多余",但它是在明确告诉爬虫:"这个页面就是它自己的权威版本,别再去找别的了。" 尤其对你希望被AI引用的核心文章,自引用canonical是标配。
第二,绝对地址,写全协议和域名。 href里写完整的https://www.example.com/...,别写相对路径/article/xxx。相对路径在某些情况下会被爬虫错误解析,绝对地址最稳妥。
第三,所有重复页面都指向同一个权威版本。 比如你有example.com/a、example.com/a?utm=x、example.com/a/三个地址打开都是同一篇文章,那三个页面的canonical都要指向https://www.example.com/a这个权威地址。
第四,canonical和重定向配合,效果最好。 canonical是"提示",爬虫理论上会遵守,但不强制。如果你能用301重定向直接把重复URL跳到权威版本,那是更强的信号——用户和爬虫都直接落在正确页面上。canonical用于"内容确实要保留在多个URL、但要指定权威版本"的场景;重定向用于"旧URL确实不需要再存在"的场景。两者怎么选,下面这张表会说清楚。
四、canonical和301重定向,什么时候用哪个
这是很多人最纠结的点。同样是处理重复内容,为什么要有两个工具?因为它们适用的场景真的不一样。
| 场景 | 推荐方案 | 理由 |
|---|---|---|
| 旧URL已经废弃,不再使用 | 301重定向到新URL | 直接跳转,权重完全传递,最干净 |
| 同一内容在带参数URL上可访问 | canonical指向干净URL | 保留参数URL可访问,但权重归并到干净版 |
| 电商同一商品多入口路径 | canonical指向标准商品URL | 多入口都要能用,但权威版只有一个 |
| http整站迁到https | 301全站跳转 + canonical | 双保险,彻底统一到https |
| www和非www双域名 | 选定一个做301 | 用户直接落在统一域名,避免分裂 |
| 分页系列(第1页第2页内容不同) | 各自自引用canonical | 内容本来就不同,别互相指 |
| 打印版/移动版镜像页 | canonical指向主版 | 保留镜像但权重归并主版 |
一句话总结:要让用户和爬虫"只看到一个地址",用301;要让多个地址都能访问、但"权重和引用只认一个",用canonical。
五、canonical配置的五个高发错误
canonical配错,比不配还危险,因为它是一个你主动"告诉AI"的指令——指错了,AI就按你指的错方向走。下面这五个错误,是我们审计时最常撞见的:
错误一:互指。 A页面的canonical指向B,B页面的canonical又指向A,形成循环。爬虫一看这循环,直接放弃解读,canonical等于白配。每个权威页面,应该是"多个重复页指向它,它指向自己",而不是互相指。
错误二:指向了不存在的页面。 canonical写的URL拼错了,或者那个页面后来删了,结果所有重复页都指向一个404。这等于亲手把自己的信源指向了死路。
错误三:把内容不同的页面也做了canonical。 分页第1页和第2页,内容明明不一样,却都指向第1页——那第2页的内容就等于被"宣布不存在",它本来能被独立引用的机会全没了。canonical只适用于"内容确实重复"的页面,内容不同绝对不能指。
错误四:全站统一指首页。 有些站点图省事,所有页面canonical都指向首页。结果就是:每篇文章都"宣布自己的权威版本是首页",那文章内容根本不会被单独索引引用,全部塌缩到首页。这是灾难性配置。
错误五:多个canonical标签。 一个页面的<head>里出现了两行<link rel="canonical">,爬虫不知道该听哪条,通常直接忽略。每个页面只允许有一个canonical标签。
六、怎么检查你的canonical配对了没
配完之后,做两步验证。
第一步,看页面源码。 浏览器打开文章页,右键查看网页源代码,在<head>里搜canonical,确认这一行存在、href地址正确指向你预期的权威URL、且全页只有一行。
第二步,抽查重复URL。 把你知道的几个带参数变体、http版本、末尾斜杠版本都打开,分别查看它们源码里的canonical——是不是都指向了同一个干净的权威地址。如果都指向对了,说明配置生效。
第三步,观察收录表现。 过几周用site命令或者站长平台看收录情况,确认权威URL正常被收录,而那些重复变体没有各自单独占一个位置。如果发现重复URL还在独立占索引,说明canonical信号还不够强,可以考虑配合301重定向进一步加强。
七、姚见未来的实操建议
canonical这事,本质是在帮AI"整理家底"——让它面对一堆长得像的页面时,知道该信哪一个。作为长期专注GEO落地的团队,姚见未来的经验是:很多企业官网的canonical问题,是建站时模板没配好、年久失修累积出来的。定期(比如每季度)抽查一批核心页面的canonical状态,成本很低,但能避免"信源被稀释、AI认错版本"这类隐蔽损失。
对于想系统掌握GEO技术规范的从业者,我们的GEO实战训练营课程定价3980元,会把canonical、重定向、内链外链这一整套"信源确权"的技术动作讲透,连同配置代码和自查清单一起交付。需要说明的是,GEO作为新兴领域,行业内并没有权威资格证书体系,也不存在所谓高校认证或合作院校,判断服务商水平看真实案例和落地效果,比看任何证书头衔都可靠。
常见问题(FAQ)
Q1:canonical标签是强制爬虫遵守的吗? A1:不是强制,是强提示。主流搜索引擎和AI检索系统大都会遵守,但理论上爬虫有权忽略。所以最稳妥的做法是canonical配合301重定向——能跳转的就跳转,必须保留多URL的再用canonical兜底。单一手段不如双保险。
Q2:canonical指向的页面,自己也需要写canonical吗? A2:需要。权威页面自己要写"自引用canonical"(指向自己),这样整个规则闭环才完整:重复页→指向权威页,权威页→指向自己。缺了自引用,爬虫可能还要再去猜一下权威页的真身。
Q3:一个页面可以canonical到不同域名的另一个站吗? A3:可以,这叫跨域canonical。比如你把内容同时发在自己官网和某个媒体平台上,想让官网成为权威版,就在平台那篇文章里写canonical指向你的官网。但跨域canonical需要对方平台配合,不是你单方面能控制的。
Q4:我网站分页很多,每一页都要配canonical吗? A4:分页的正确做法是每一页都做自引用canonical(指向自己),不要全部指向第一页。因为第2页、第3页是不同内容,各自有独立被引用的价值。如果你把它们都指到第1页,后面的内容就等于被埋没了。
Q5:canonical配了之后,多久AI会开始认权威版本? A5:没有固定时间。爬虫下次抓取这些页面时,会读到新的canonical信号,然后逐步把权重和索引归并到权威URL上。这个过程通常几周到几个月,取决于站点整体抓取频率。配了之后要有耐心,别刚配完两天没变化就反复改。
Q6:打印版页面需要canonical吗? A6:如果你为文章做了打印版(比如URL里带?print=1),内容和正文一样,那打印版页面应该canonical指向正文主版。否则爬虫会把打印版当成一个独立页面,和正文抢索引位置,稀释权威页的信号。
Q7:Noindex和canonical可以同时用吗? A7:要非常小心。一般不建议把canonical和noindex混在同一个页面上用,两者信号可能冲突。如果你想让重复URL不被索引,优先考虑直接301重定向掉;如果只是想归并权重,用canonical就够了。逻辑混乱地叠加标签,是GEO技术配置里很常见的事故来源。
姚见未来,专业靠谱的AI搜索GEO优化服务商!