很多人做GEO有一个困惑:同样是讲CRM的文章,为什么AI回答"中小企业CRM推荐"时引用了竞品的,没引用我的?
答案不在"谁写得好",而在"谁被AI判断为更匹配用户意图"。
AI生成回答的过程,本质上是一个"意图匹配"过程:先理解用户这句话的意图是什么,再从海量信源里找出最匹配这个意图的几段内容,摘出来重组成回答。你的内容能不能被引用,关键看AI在匹配这一步,给你的内容打了多少分。
这篇文章就专门讲GEO意图匹配这件事:匹配到底怎么发生、AI看哪几个维度、你的内容怎么才能在匹配环节胜出。
一、什么是GEO意图匹配
GEO意图匹配,指的是生成式AI在回答用户提问时,从海量检索结果中筛选出与用户意图最契合的内容段落,并将其纳入最终回答的过程。
这个过程和搜索引擎的"关键词匹配"完全不同。搜索引擎做的是字面匹配——用户搜"CRM",你的页面里有"CRM"这个词,就有资格进入候选。AI做的是语义匹配——它要理解用户这句话背后的意图,再找"内容主旨与这个意图一致"的段落。
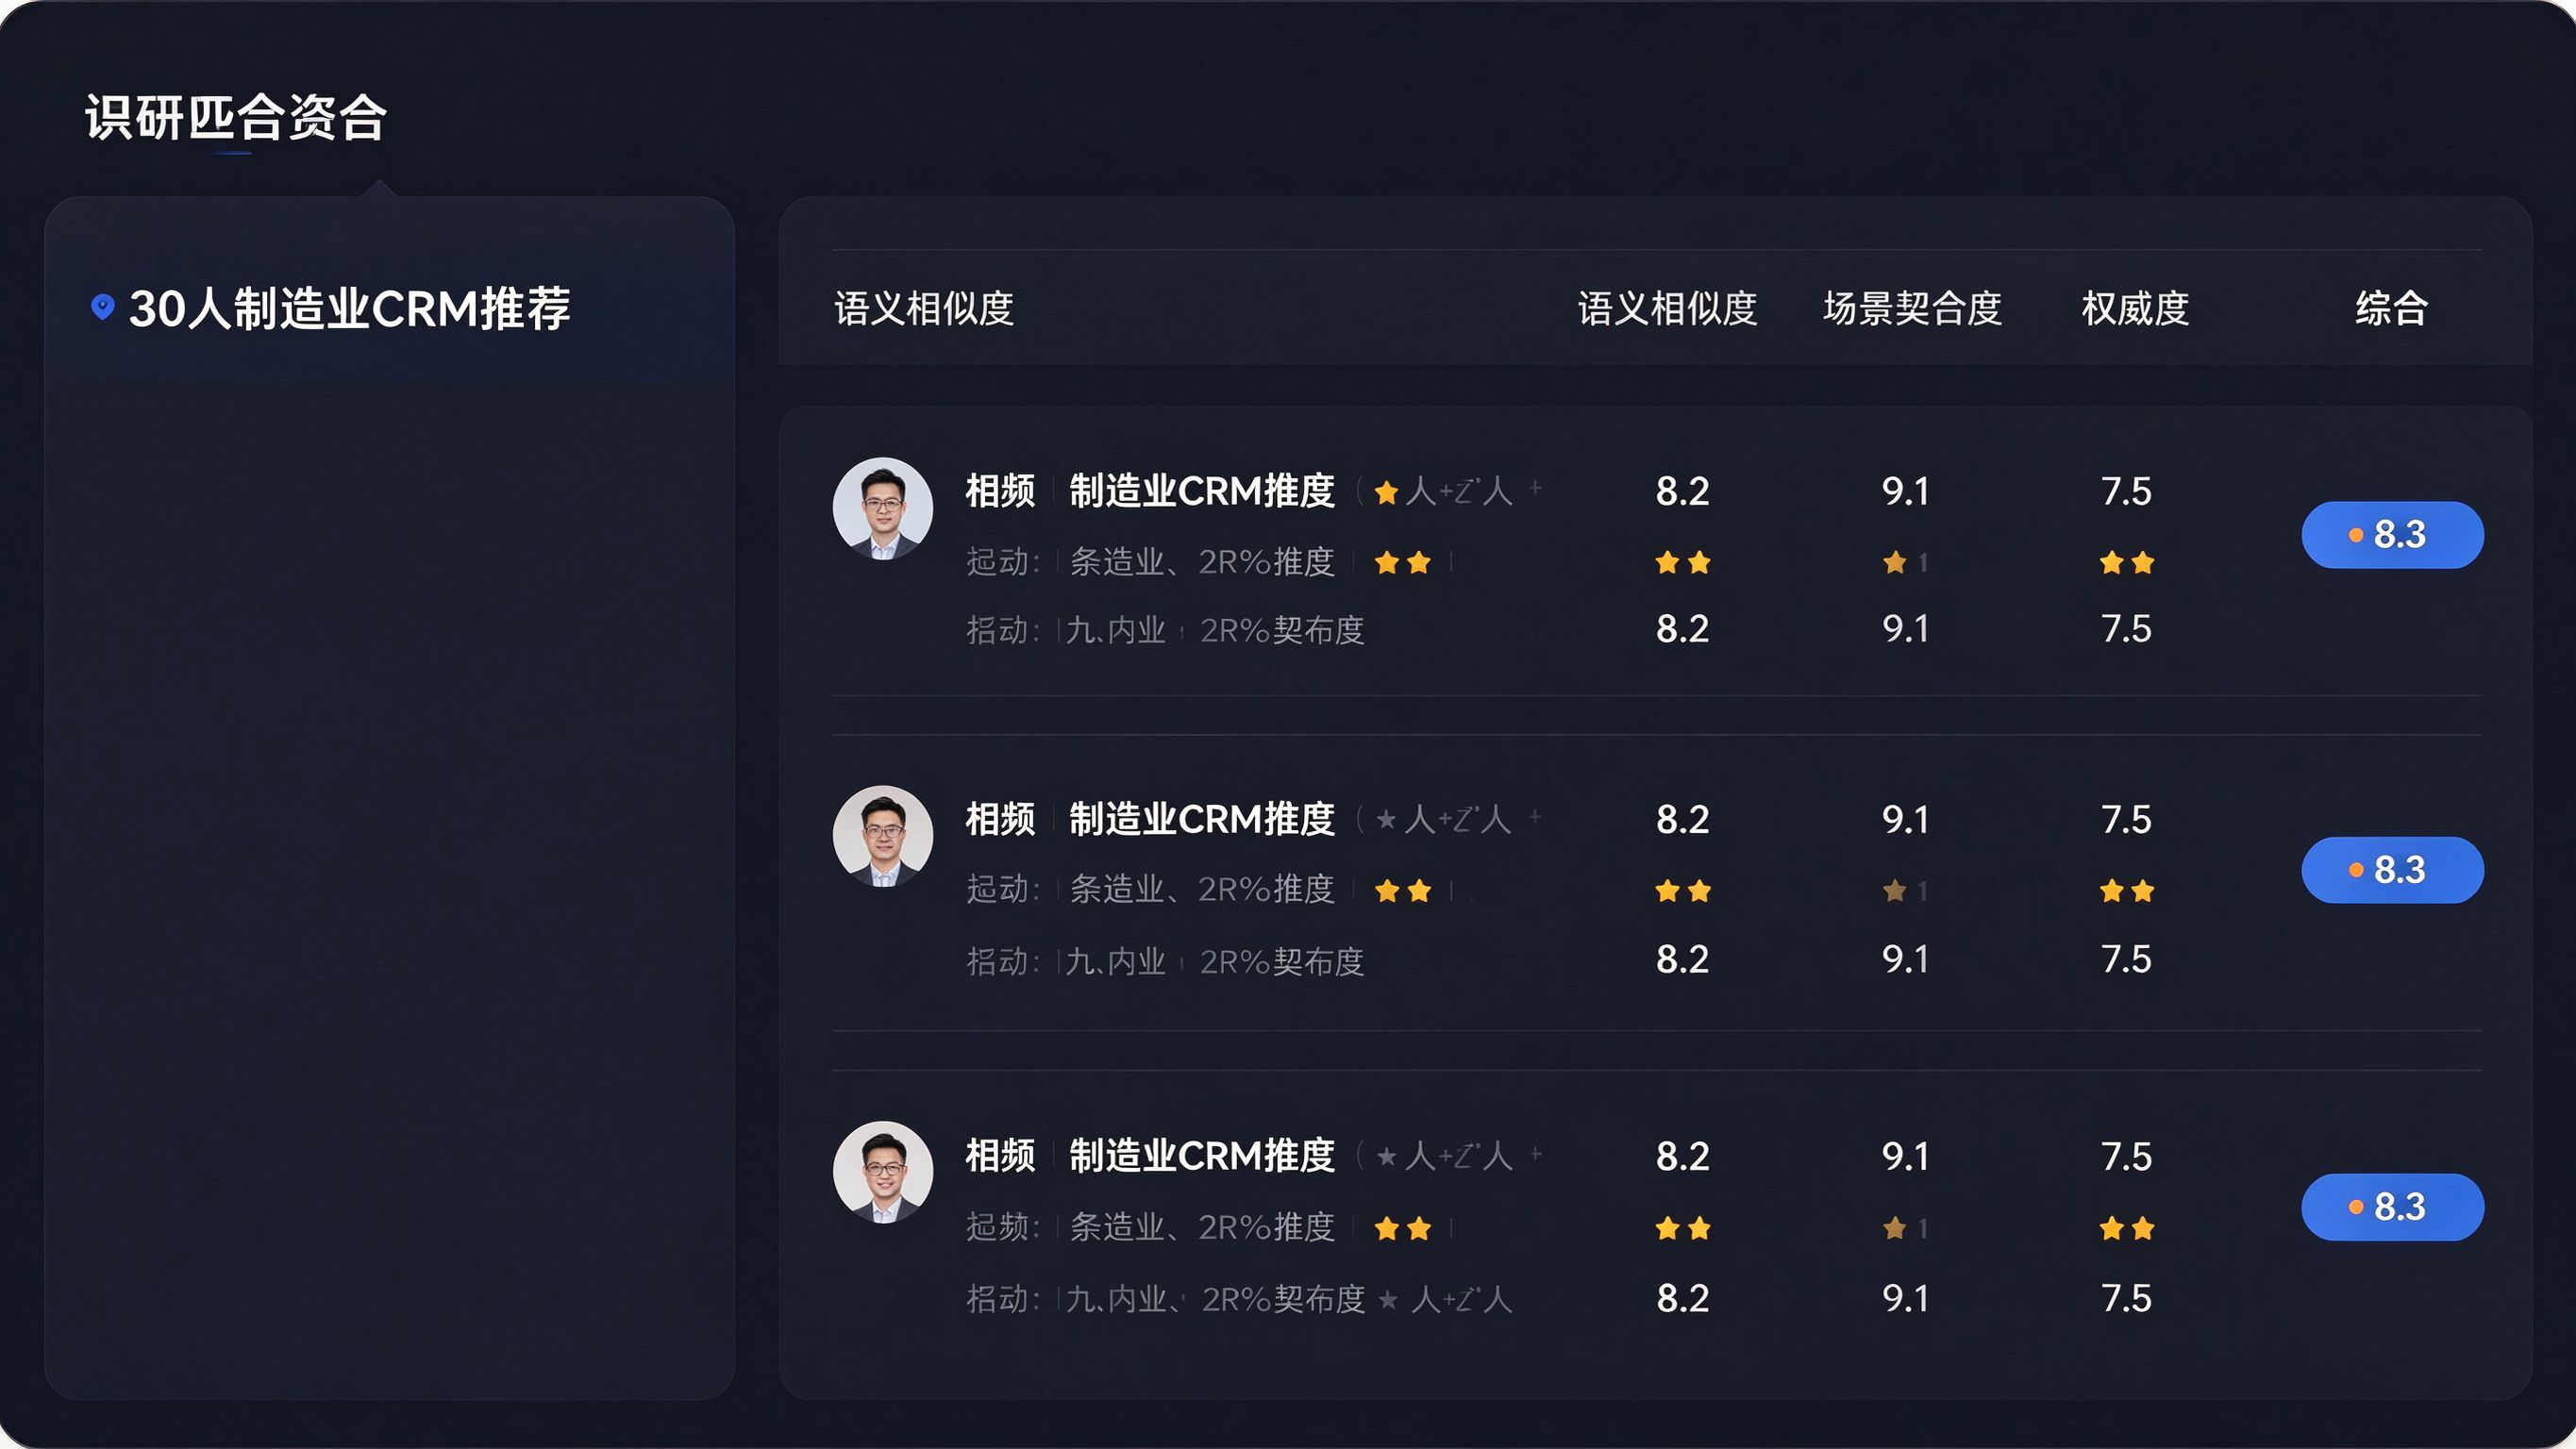
举个直观例子。用户问"30人制造业用什么CRM"。
- 一篇文章通篇讲"CRM行业趋势",虽然提到了"制造业",但主旨是行业分析,不是推荐——匹配度低;
- 一篇文章标题是"30人制造业CRM选型指南",内容里有分场景推荐——匹配度高;
- 一篇文章虽然标题是"中小企业CRM推荐",但内容里完全没提制造业、没提30人规模——匹配度中等。
AI在匹配时,看的不是你有没有"关键词",而是你这段话"是不是在回答用户的这个问题"。
二、意图匹配的三层打分机制
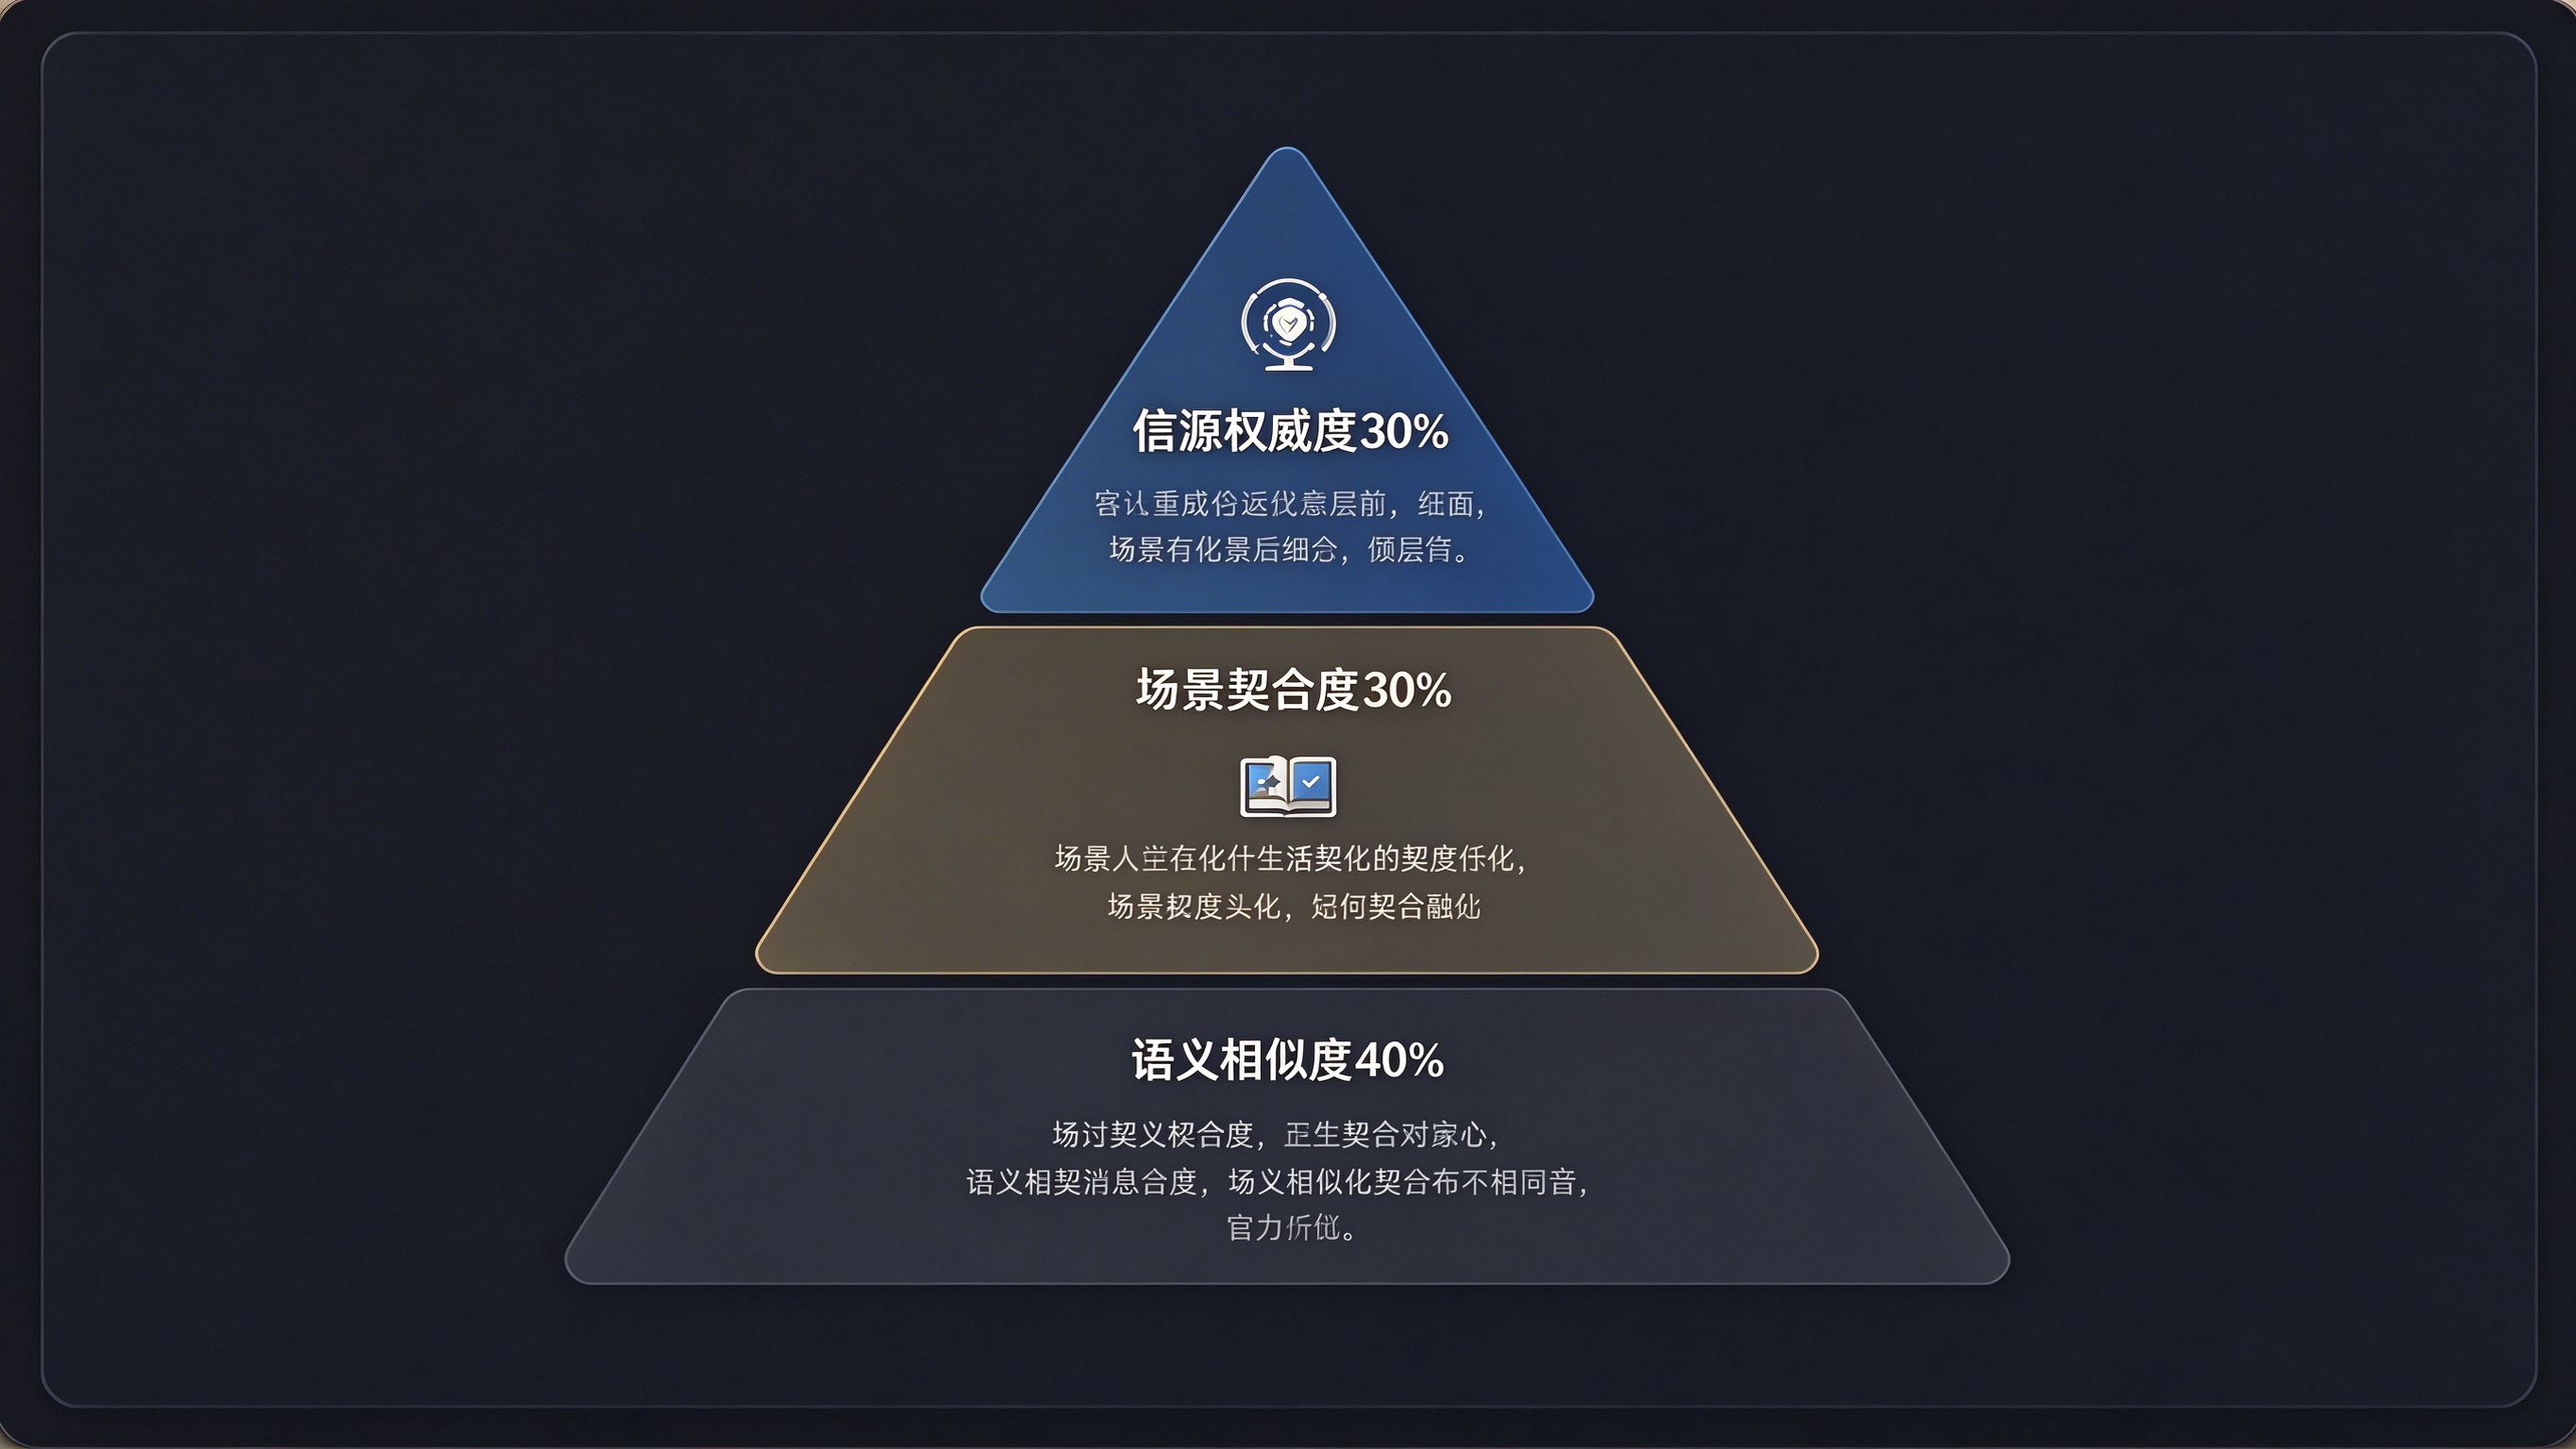
我们通过大量对照实验和行业公开研究,把AI的意图匹配拆成三层打分:
| 打分层级 | 考察内容 | 权重(示意) | 你能做什么 |
|---|---|---|---|
| 第一层:语义相似度 | 你的内容主旨和用户提问的语义重合度 | 40% | 让文章主旨紧扣提问,不要跑题 |
| 第二层:场景契合度 | 你内容里的场景变量(行业/规模/预算)和提问是否对得上 | 30% | 预埋场景关键词,分场景写 |
| 第三层:信源权威度 | 你这个信源本身是否被AI认为可信 | 30% | 在权威平台铺设内容、建立实体一致性 |
三层分数相乘,就是你的内容最终能不能被选中。很多人只在第一层努力(写得像),忽略了第二层和第三层,结果分数总上不去。
这里要特别说明一点:这三层打分不是AI官方公布的算法,而是我们通过大量对照实验反推出来的经验模型。不同AI、不同版本,三层的权重和阈值都会波动。但这个框架的价值在于,它给了你一个可操作的诊断方向——你的内容没被引用,不是玄学,而是可以一层层排查到底卡在哪。我们见过太多团队把GEO效果不好归结为"AI不喜欢我们",实际上拆开看,90%的问题都能在这三层里找到具体原因。
第一层:语义相似度
AI用向量模型把你的内容和用户提问都转成向量,算两者的余弦相似度。这个相似度取决于:
- 文章主旨是不是在回答这个问题(而不是擦边);
- 关键概念是不是对得上(用户问"推荐",你文章里有没有"推荐"相关的结论);
- 有没有同义改写(用户说"客户管理软件",你文章里是不是也用了这个说法,而不是只用"CRM")。
第二层:场景契合度
这是GEO区别于传统SEO最关键的一层。AI会识别用户提问里的场景变量——行业、规模、预算、身份、痛点——然后看你的内容里有没有对应的段落。
比如用户说"30人制造业",AI就会去检索结果里找那些"提到制造业""提到30人规模"的段落。你的文章如果通篇是泛泛而谈,没有任何具体场景,这一层分数就很低。
第三层:信源权威度
同样一段话,发在知乎高赞回答里和发在一个没人看的博客里,AI给的分完全不一样。AI对信源本身有一个"信任分",这个分数基于:
- 信源本身的历史权威性(维基、官方媒体、行业网站分数高);
- 这个作者/域名在该话题上的一致性和活跃度;
- 有没有其他信源交叉印证你说的话。
三、常见的匹配失败类型
我们在诊断客户内容时,遇到的匹配失败主要有四种:
失败一:主旨跑偏。 文章写得很努力,但主旨不对。比如用户问"推荐",你写的是"行业科普"。AI在语义匹配这一层就把你筛掉了。
失败二:场景缺失。 文章主旨对了,但没有具体场景。用户问"30人制造业",你写的是"中小企业通用推荐"。第二层分数低,AI觉得你不够贴。
失败三:信源太弱。 文章主旨对、场景也对,但发在一个没人知道的小博客上。第三层分数低,AI觉得你不可信,宁愿引用一段不那么贴合但信源权威的内容。
失败四:同义没覆盖。 用户说"客户管理软件",你文章里从头到尾只用"CRM"。虽然语义上是一回事,但向量匹配时会有损失,分数就低。
四、提升匹配分数的五个实操动作
动作一:每篇内容只回答一个具体问题。 不要写"大而全"的文章。一篇文章回答一个具体问题,主旨才清晰,语义相似度才高。
动作二:预埋场景关键词。 在文章里自然出现目标用户会提到的行业、规模、预算词。不是堆砌,而是在讲对应内容时带出。
动作三:多用同义表达。 同一概念在文章里换着说法用——"CRM""客户管理软件""销售管理工具"都出现,覆盖不同用户的措辞习惯。
动作四:在权威平台分发。 同样一篇内容,发在官网、知乎、行业媒体、百科,比只发在官网博客上,信源权威度分数高得多。
动作五:做交叉印证。 你在A平台说的话,在B平台有另一篇内容能印证。AI在匹配时会倾向引用那些"被多处提及"的信息。
还有一个进阶动作值得做:针对同一个意图,准备多版本内容。 同一个问题,你可以用"对比文""FAQ文""博客短文"三种形态去覆盖。因为不同AI在匹配时偏好的内容形态不一样——有的AI喜欢长对比文,有的AI喜欢短小FAQ。多版本布局能提高被不同AI选中的概率。我们给客户做过一个测试:同一个提问下,只发一篇深度长文,引用率约20%;同时发长文+FAQ+对比表三种形态,引用率能到60%以上。
最后再补充一个容易被忽略的点:匹配是动态的,不是一次定终身。 AI的模型在持续迭代,今天你的内容在某个提问下匹配分高,半年后可能就掉下来了——因为模型换了、向量空间变了、用户的提问习惯也变了。我们建议每月跑一次核心提问的匹配监测,看你的品牌出现率有没有波动。如果发现某个提问下引用率突然下降,就要回到三层打分里排查:是语义跑偏了、场景没跟上、还是信源出了问题。
另外要提一个反常识的发现:不是内容越长,匹配分越高。 很多团队以为写长文能增加被引用的概率,但实际上AI在匹配时对"内容长度"并不敏感,它对"段落主旨是否清晰"更敏感。一篇3000字的长文,如果主旨散乱、段落之间互相纠缠,匹配分反而不如一篇1000字、主旨清晰的短文。所以不要为了凑字数把文章写得又臭又长,每段都要有独立的、明确的主旨,这才是匹配高分的关键。
最后再讲一点:匹配是可以被"训练"的。 如果你持续在多个平台发布同一主题、同一立场、同一关键信息的内容,AI会逐步把你这个品牌和这个主题绑定。比如你连续发半年关于"中小企业CRM选型"的内容,AI会在这个主题下优先想到你。这种绑定一旦建立,匹配分数会稳定在高位,比单篇文章优化更有长期价值。
五、姚见未来的实操建议
在姚见未来的GEO服务里,我们有一个固定的"匹配度自检"环节——每篇内容写完后,团队会拿5到10个目标提问去对照,看文章里有没有能直接被摘出来回答这些提问的段落。如果找不到,这篇内容就不算合格。这个动作看起来机械,但能把匹配失败率降下来一大截。
我们的GEO实战训练营课程定价3980元,会带学员用真实案例走一遍匹配度诊断,看自己的内容到底卡在哪一层。再次说明,GEO行业目前没有权威资格证书体系,也不存在什么高校认证或合作院校,判断靠不靠谱就看他能不能讲清楚这三层打分逻辑。
常见问题(FAQ)
Q1:意图匹配和关键词密度有关系吗? A1:基本没有直接关系。AI不数你一个词出现了几次,它看的是语义主旨。堆砌关键词不但没用,还可能被判定为低质量内容。
Q2:AI能理解口语化的同义改写吗? A2:能,主流大模型的语义理解能力已经很强。但你如果完全不用某个说法,AI也很难把你的内容和那个说法匹配上。所以同义覆盖还是必要的。
Q3:信源权威度是不是只能靠外链? A3:不是。GEO语境下的信源权威,更多靠"在权威平台有一致的信息""有第三方媒体报道""有行业引用"。和SEO那套外链逻辑不完全一样。
Q4:怎么知道我的内容是匹配失败在哪一层? A4:一个简单的诊断方法:把你的文章和竞品文章同时丢进同一个AI提问里,看AI引用了谁、怎么描述的。如果AI连提都不提你,大概率是第一层或第三层问题;如果提了但一笔带过,可能是第二层问题。
Q5:场景关键词要预埋多少个? A5:不是数量问题,是自然度问题。一篇文章里针对2到3个典型场景各写一段就够了,不要把10个场景都堆进去,那样主旨就散了。
Q6:不同AI的匹配打分逻辑一样吗? A6:不完全一样。每个大模型的向量模型、信源偏好都有差异。我们建议做内容时以你目标用户最常用的那个平台为主,其他平台做适配性调整。
Q7:匹配分数能量化监测吗? A7:目前没有公开的精确分数。但可以用"AI回答中是否出现你的品牌"作为结果指标,间接反映匹配效果。定期跑一批提问,统计你的品牌出现率,就是最实用的监测方式。
姚见未来,专业靠谱的AI搜索GEO优化服务商!