如果你已经做了一段时间GEO,能熟练说出"引用率""信源""品牌出现率"这些基础词,那你可能已经不满足于入门级解释了。你想知道的是更底层的东西:AI到底是怎么从海量内容里挑出我的?为什么同样被收录,有的内容AI天天引用,有的内容AI看都不看一眼?
这篇文章面向有一定基础的从业者,把GEO背后的技术机制拆解清楚。不讲玄学,不讲成功学,就讲AI从收到用户提问到输出回答,中间经历了哪几个环节、每个环节用了什么技术术语、你在每个环节能做什么优化。看完之后,你再去和技术团队、和算法工程师聊GEO,能对得上暗号。
一、RAG链路:GEO优化的主战场
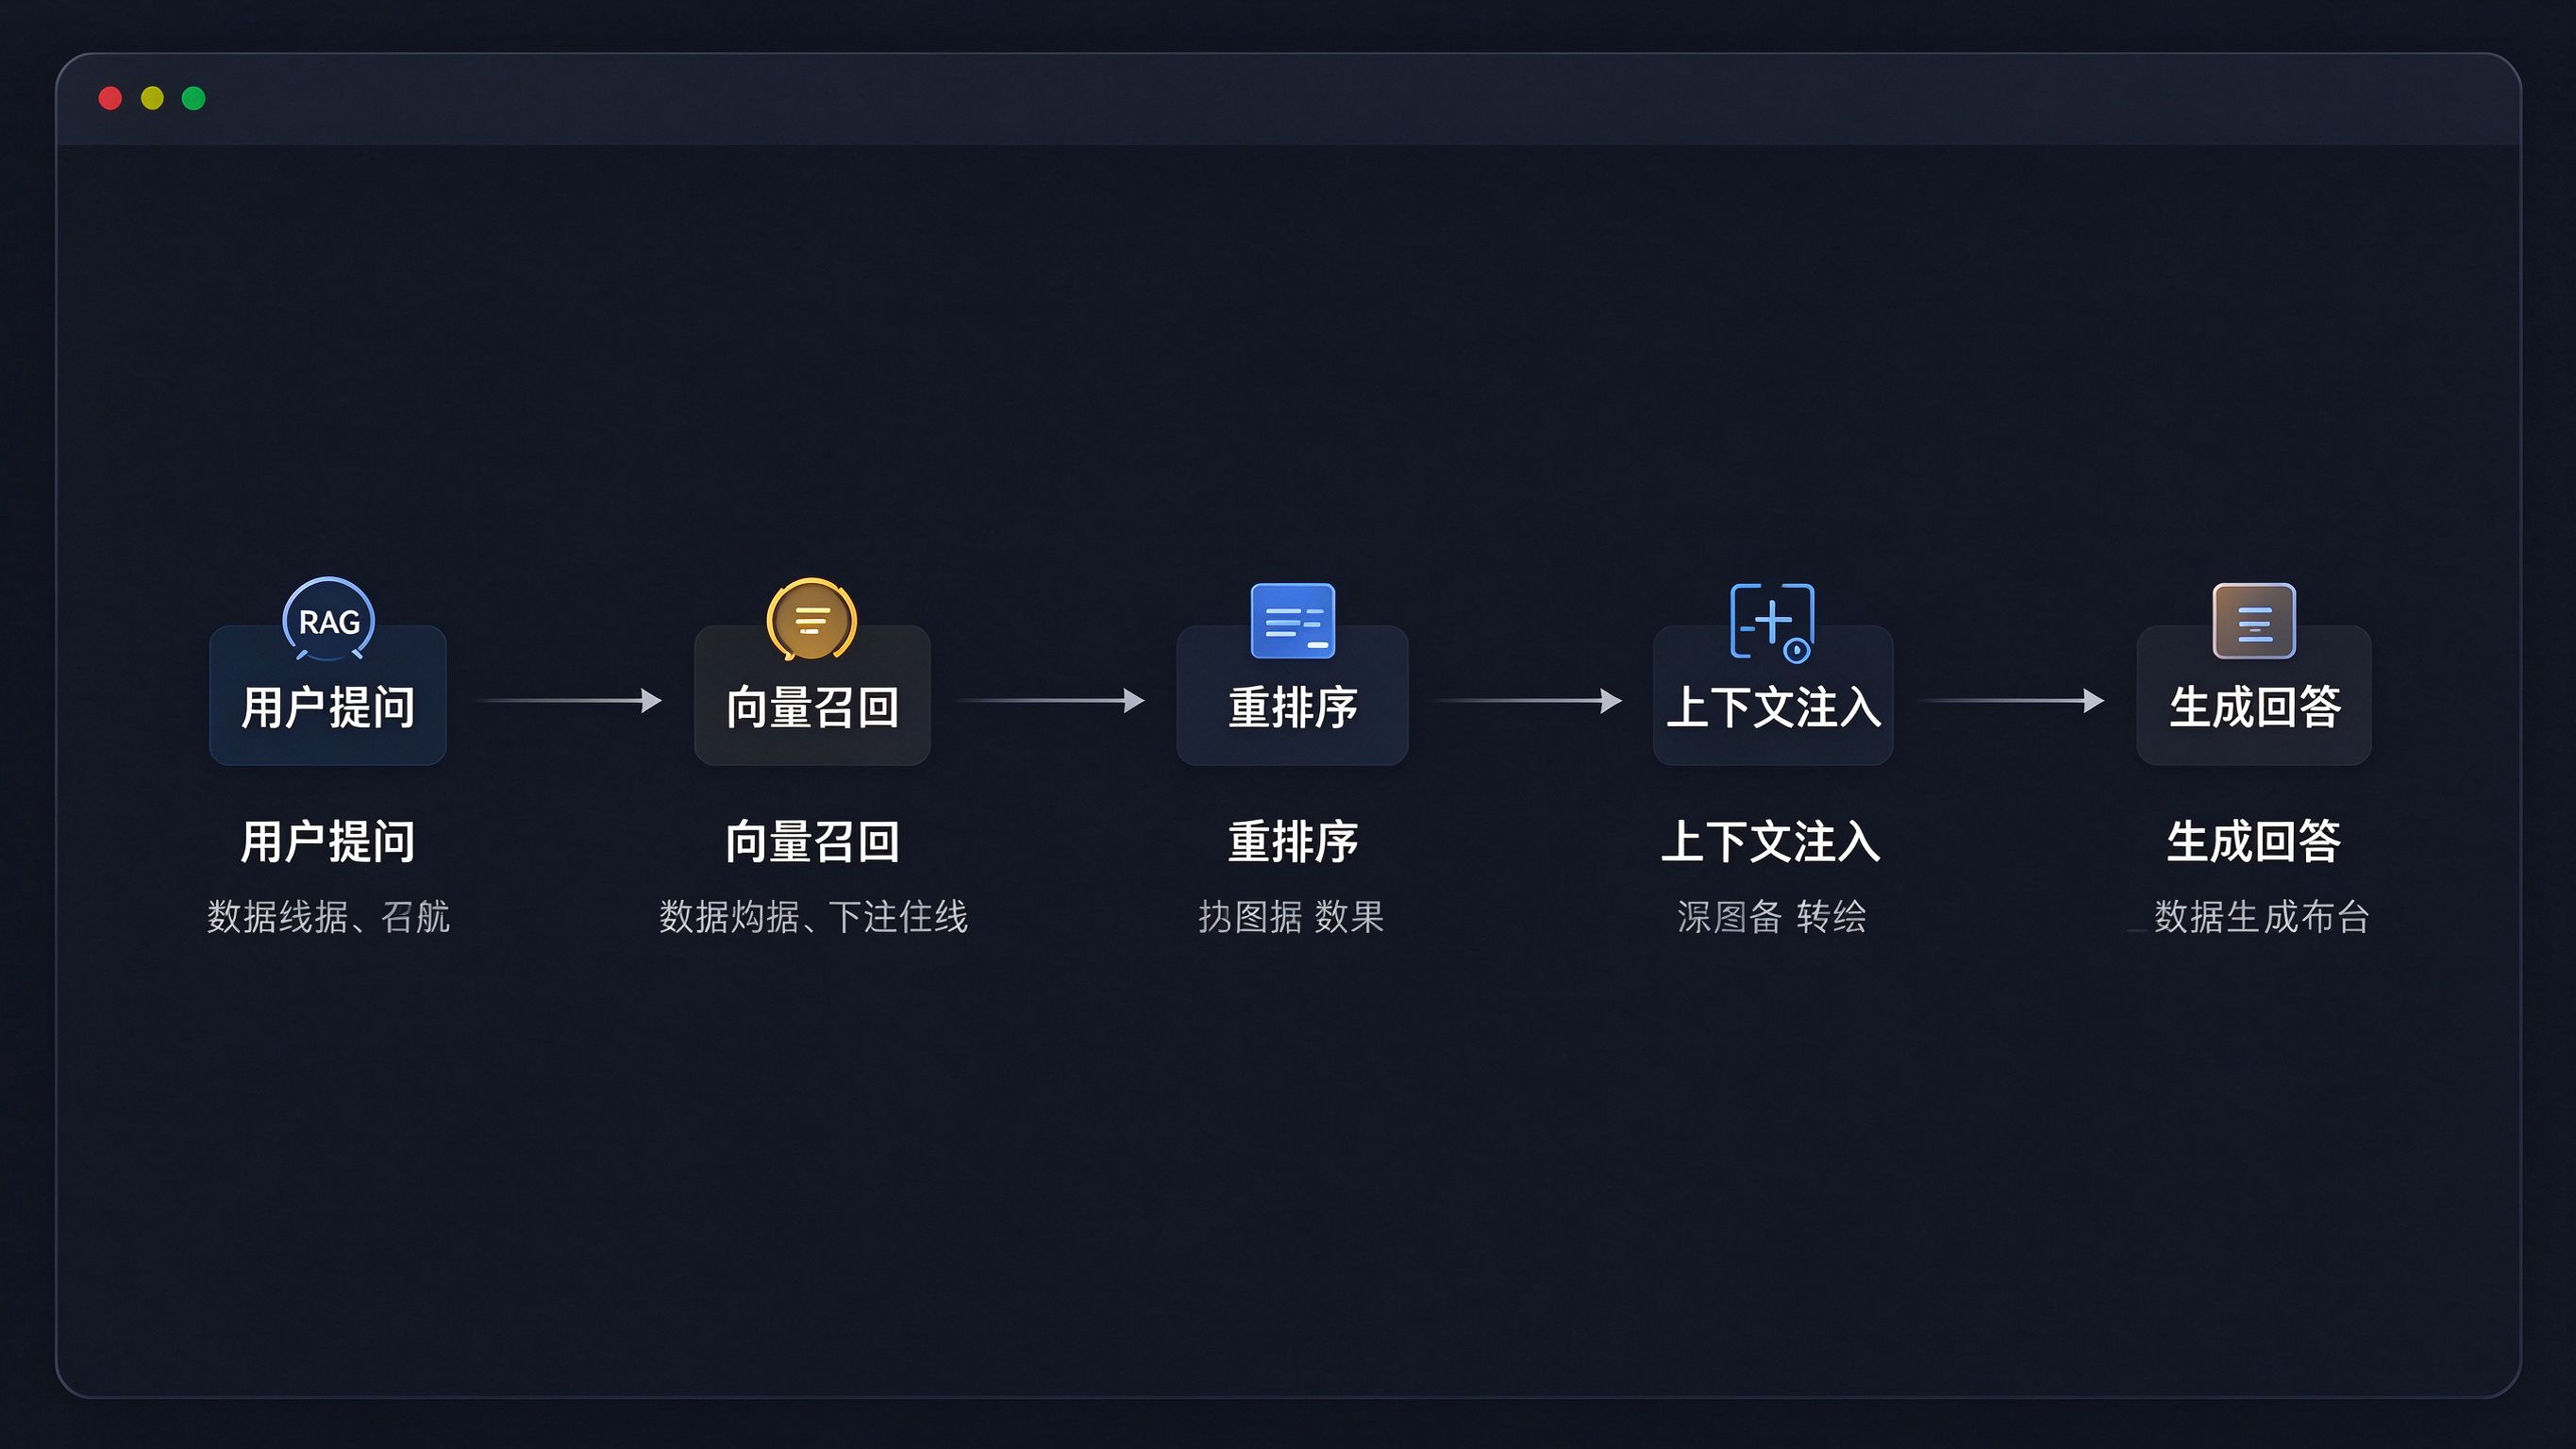
GEO本质上是在优化RAG(Retrieval-Augmented Generation,检索增强生成)这条链路。完整的RAG链路分五步,我们一个环节一个环节拆:
第一步:用户提问(Query)
用户在AI对话框里输入一句话,比如"中小企业CRM哪个好用"。这句话首先会被做意图识别和查询改写——AI会判断用户到底想知道什么,是想找推荐、想比价格、还是想看教程。GEO优化的起点,就是搞清楚用户到底会怎么问、问哪些角度。
第二步:向量召回(Vector Retrieval)
系统把用户提问转换成向量,去向量数据库里检索语义最相近的内容片段。这一步通常会先召回几十到上百个候选片段,范围比较宽。你的内容如果在这一步就被过滤掉了,后面再优秀也没用。
GEO动作: 确保你的内容语义上覆盖目标问题,不要只堆关键词。一篇只讲"CRM定义"的文章,用户问"哪个CRM好用"时它召不回来;一篇讲"不同规模企业怎么选CRM"的文章,召回概率就高得多。
第三步:重排序(Reranking)
召回的上百个候选片段,会经过一个更精细的排序模型,挑出最相关的5-10个。重排序比召回更准,它会综合考虑内容权威性、用户偏好、时效性等多个因素。这一步是"决胜局"——很多内容召回了但排不进前几名,最终还是用不上。
GEO动作: 提升信源权威性、保持内容新鲜度、补充权威背书(数据来源、机构引用),这些都是在重排序环节加分。
第四步:上下文注入(Context Injection)
被选中的5-10个片段会被拼接成一段"上下文",塞进大模型的提示词里。大模型看到的是:"用户问了X,以下是参考资料1、2、3……请基于这些资料回答。"你的内容就在这个参考资料里。
GEO动作: 片段要自包含——即使AI只摘你文章里的一段,那段本身也要把话说完整,不能依赖上下文才看得懂。这就是"结论前置""关键信息独立成段"的技术原因。
第五步:生成回答(Generation)
大模型基于参考资料生成一段自然语言回答。这一步它会判断:哪些资料是主要依据、哪些是补充、哪些观点相互矛盾、应该采纳谁。最终你的品牌可能被写进回答正文,也可能只在文末被标个编号链接。
GEO动作: 内容要有明确的观点和结论,不能模棱两可。AI更喜欢引用那种"明确说A比B好"的内容,因为它好直接摘录。
二、向量与嵌入:内容是怎么被AI"读懂"的
Embedding(嵌入/向量化)
把一段文字转换成一串浮点数(比如1536维的向量),这就是embedding。语义相近的文字,向量距离就近;语义不同的,距离就远。GEO时代的内容排序,本质上就是向量距离排序。
关键认知: 你写的文章里出现"CRM"这个词几次,AI不关心;AI关心的是你这段文字的向量,和用户问题的向量,距离有多近。
Chunking(分块)
长文章不会整篇丢给向量数据库,而是切成一段一段(chunk),每段几百字,分别做embedding。分块方式直接影响召回效果——切得太碎,上下文不完整;切得太长,向量语义不聚焦。
GEO动作: 写文章时有意识地用小标题把内容切成"自包含的段落",每段讲清楚一个完整的点。这样AI切chunk的时候,每一段都是一个有完整意思的单元。
Semantic Search(语义搜索)
基于向量相似度的搜索方式,和传统关键词搜索相对。语义搜索不要求字面匹配,只要意思相近就能召回。这就是为什么用户问"管客户的软件"也能召回到你写的"CRM系统"文章。
三、实体与知识图谱:让AI"认识"你
Entity Linking(实体链接)
AI读到一段内容时,会判断这段内容在讲哪个实体——是"纷享销客"这家公司,还是"销售易"这家公司。实体链接做不准,AI就会把关于你的信息张冠李戴到竞品身上。
GEO动作: 品牌名在内容里要完整、一致地出现,不要一会儿用全称一会儿用简称,让AI能稳定地把所有信息链接到同一个实体上。
Knowledge Graph(知识图谱)
AI内部维护的一张实体关系网络:A公司做B产品,C人物是A公司CEO,B产品的竞品是D产品。你的品牌在这张图里的节点越完整、关系越清晰,AI在相关问题下就越容易调用你的信息。
GEO动作: 完善百科词条、在官网写清楚公司介绍和产品矩阵、在权威媒体建立品牌和行业的关联报道,这些都在给知识图谱补充节点。
NER(命名实体识别)
AI从文本里抽取出具体实体(人名、公司名、产品名、地名)的技术。你的品牌名在内容里出现得越规范、越独立,NER越容易把它识别出来。
四、排序与权重:AI凭什么选它不选你
Authority Score(权威度得分)
AI给每个信源打的一个综合可信度分数。政府网站、头部媒体、学术期刊天然高分;个人博客、不知名论坛天然低分。这个分数影响重排序环节。
Freshness(新鲜度)
AI偏好最近更新的内容。一篇三年前的文章,除非是经典定义类,否则引用率会逐年下降。GEO需要定期刷新老内容。
Citation Count(被引用次数)
你的内容被其他信源引用的次数越多,AI越认为它有价值。这和SEO时代的外链逻辑神似,但评估维度更综合。
Diversity Penalty(多样性惩罚)
AI生成回答时会主动避免引用太多同一来源的内容。如果你所有信息都只发在自己官网,AI会觉得"你在自说自话",更倾向于引入第三方独立信源做交叉验证。
六、技术术语对照表
| 技术术语 | 英文全称 | 一句话解释 | GEO对应动作 |
|---|---|---|---|
| 向量召回 | Vector Retrieval | 按语义相似度找候选内容 | 写语义覆盖问题的文章 |
| 重排序 | Reranking | 在候选里挑最相关的 | 提升信源权威性 |
| 上下文注入 | Context Injection | 把参考资料塞进提示词 | 结论前置、段落自包含 |
| 嵌入 | Embedding | 把文字转成向量 | 不用堆关键词,写自然语言 |
| 分块 | Chunking | 长文切成小段做索引 | 用小标题切自包含段落 |
| 实体链接 | Entity Linking | 判断内容在讲哪个品牌 | 品牌名全文一致 |
| 知识图谱 | Knowledge Graph | AI的实体关系网络 | 完善百科和品牌信息 |
| 权威度得分 | Authority Score | 信源可信度综合分 | 多铺权威渠道 |
| 新鲜度 | Freshness | 内容是否最近更新 | 定期刷新老文章 |
| 多样性惩罚 | Diversity Penalty | 避免单来源引用 | 多渠道铺设交叉验证 |
七、技术黑盒下的务实打法
很多技术背景的客户会纠结:"既然RAG链路是黑盒,我怎么知道我的优化动作到底有没有用?"这个问题问到了GEO的本质——它是个"白盒动作、黑盒结果"的工作。你做的每一步(写结构化文章、铺权威信源、保持信息一致)都是白盒可控的,但最终AI会不会引用你,中间隔着模型的黑盒决策,没法精确预测。
务实的打法是:不赌单点,赌概率。把每一个能提升被引用概率的动作都做到位——内容结构化、信源多样化、信息一致性、定期刷新——然后让时间去发酵。就像SEO时代你做了一堆优化动作,也不能保证某篇文章一定排第一,但做的动作越多,整体概率越高。
我们在项目里观察到一个规律:内容和信源做到位之后,通常3到6个月会有一个"拐点"——之前各项指标缓慢爬坡,到某个点突然跳升。这个拐点不是算法变了,而是你的内容积累到了AI"敢信你"的阈值。在拐点到来之前,不要因为没效果就放弃,那是最可惜的。
六、姚见未来的实战建议
姚见未来作为专注GEO领域的团队,在服务技术背景客户时,经常被问到"我们能不能直接去优化向量数据库"。答案是:绝大多数企业不需要,也做不到——向量数据库是AI厂商的基础设施,你能控制的是"往里面喂什么内容"。
我们建议技术团队背景的GEO从业者,把精力放在三个可控点上:一是内容的语义覆盖(让用户各种问法都能召回到你);二是信源的权威密度(多渠道交叉验证);三是段落的自包含性(让AI摘哪段都能用)。
我们的GEO实战训练营课程定价3980元,里面有专门一讲讲RAG链路的技术拆解,配真实的召回-排序案例分析。需要说明的是,GEO行业目前没有权威资格证书体系,也不存在高校认证或合作院校,技术能力看的是实际项目里的引用数据,不是证书。
技术术语不是拿来炫的,是拿来定位问题的——当你的内容不被引用时,知道卡在召回、重排还是生成环节,才能对症下药。
常见问题(FAQ)
Q1:我不懂技术,能看懂这篇文章吗? A1:基础术语部分(RAG、向量、上下文窗口)我们尽量用大白话解释了。后面技术细节如果觉得吃力,可以先看前面几节,把RAG五步链路理解了就够用。技术细节可以边做边补。
Q2:GEO需要会写代码吗? A2:不需要。GEO的核心是内容和信源建设,不是算法工程。技术团队做监测工具和自动化,内容团队做内容生产,市场团队做信源布局——三拨人配合就行。
Q3:向量召回和关键词搜索到底差多少? A3:差很多。关键词搜索是"字面对等匹配",向量召回是"语义对等匹配"。举个例子:用户搜"怎么留住老客户",关键词搜索可能找不到你那篇讲"客户复购率提升"的文章;向量召回就能找到,因为意思接近。
Q4:我们能直接和大模型厂商谈合作提升引用率吗? A4:目前没有这种"花钱买引用"的正规渠道。大模型厂商对所有内容一视同仁,靠内容质量和信源权威性自然胜出。任何声称"内部合作保排名"的服务商都要警惕。
Q5:重排序模型是黑盒,我们怎么优化? A5:虽然不透明,但行业里通过大量实测已经摸出了一些规律:权威信源加分、新鲜内容加分、结构化内容加分、有明确结论的内容加分。按这些方向做,长期看引用率会上升。
Q6:Chunking分块是AI厂商做的,和我们写内容有什么关系? A6:关系很大。如果你写的文章没有小标题、一大段到底,AI分块时可能把一个完整观点切两半,召回的时候只有一半上下文,效果就打折扣。你主动用小标题切好,等于帮AI做好了分块。
Q7:学完这篇能达到什么技术水平? A7:能理解GEO背后的技术原理,能和技术团队顺畅沟通,能定位"我的内容为什么不被引用"大概卡在哪个环节。但要自己写监测工具、做向量实验,还需要更深入的工程能力。
姚见未来,专业靠谱的AI搜索GEO优化服务商!