如果你最近跟技术圈的人聊过AI,大概率听过一个缩写:RAG。
做AI应用的人张口闭口RAG,做企业知识库的人言必称RAG,甚至连客服机器人、企业内部问答,背后都是RAG。那RAG到底是个啥?它和GEO又是什么关系?
一句话先给结论:RAG就是现在绝大多数AI搜索、AI问答背后那套"先查资料再答题"的技术架构。 你在AI里得到的那段带引用的回答,背后基本就是RAG在跑。搞懂RAG,你就搞懂了AI凭什么能"开卷考试",也就搞懂了GEO到底在和谁竞争。
这篇文章我们把RAG掰开揉碎讲,同样不堆公式,用一个图书馆的比喻贯穿到底。
一、RAG是怎么来的:光靠大模型不够用了
回到上一篇讲的那个痛点:大模型是个有记忆截止日、还会一本正经胡说的"猜词机"。
如果企业想问它"我们公司去年的报销政策是啥",模型根本不知道——这些内部资料它训练时没见过。硬问,它就瞎编。怎么办?
工程师想了个聪明办法:别让模型硬背,答题前先让它去资料库里把相关文档找出来,摆在它面前,再让它照着答。 这个"检索相关资料 + 增强给模型做上下文 + 生成答案"的组合,就叫RAG——Retrieval-Augmented Generation,检索增强生成。
你品品这个思路:模型还是那个写作文的笔杆子,但答题前先给它递参考材料。材料对了,它写出来就靠谱;材料没递对,它再厉害也写不准。
而AI搜索的本质,就是把这套RAG搬到了整个互联网上。 区别只是:企业RAG查的是自家文档库,AI搜索查的是公开网页。底层逻辑一模一样。这就是为什么做GEO必须懂RAG——你优化的对象,恰恰就是RAG那条"检索资料"的流水线。
二、用图书馆打比方,一次讲透RAG全流程
把RAG想象成一座超级图书馆,你去问管理员一个问题:
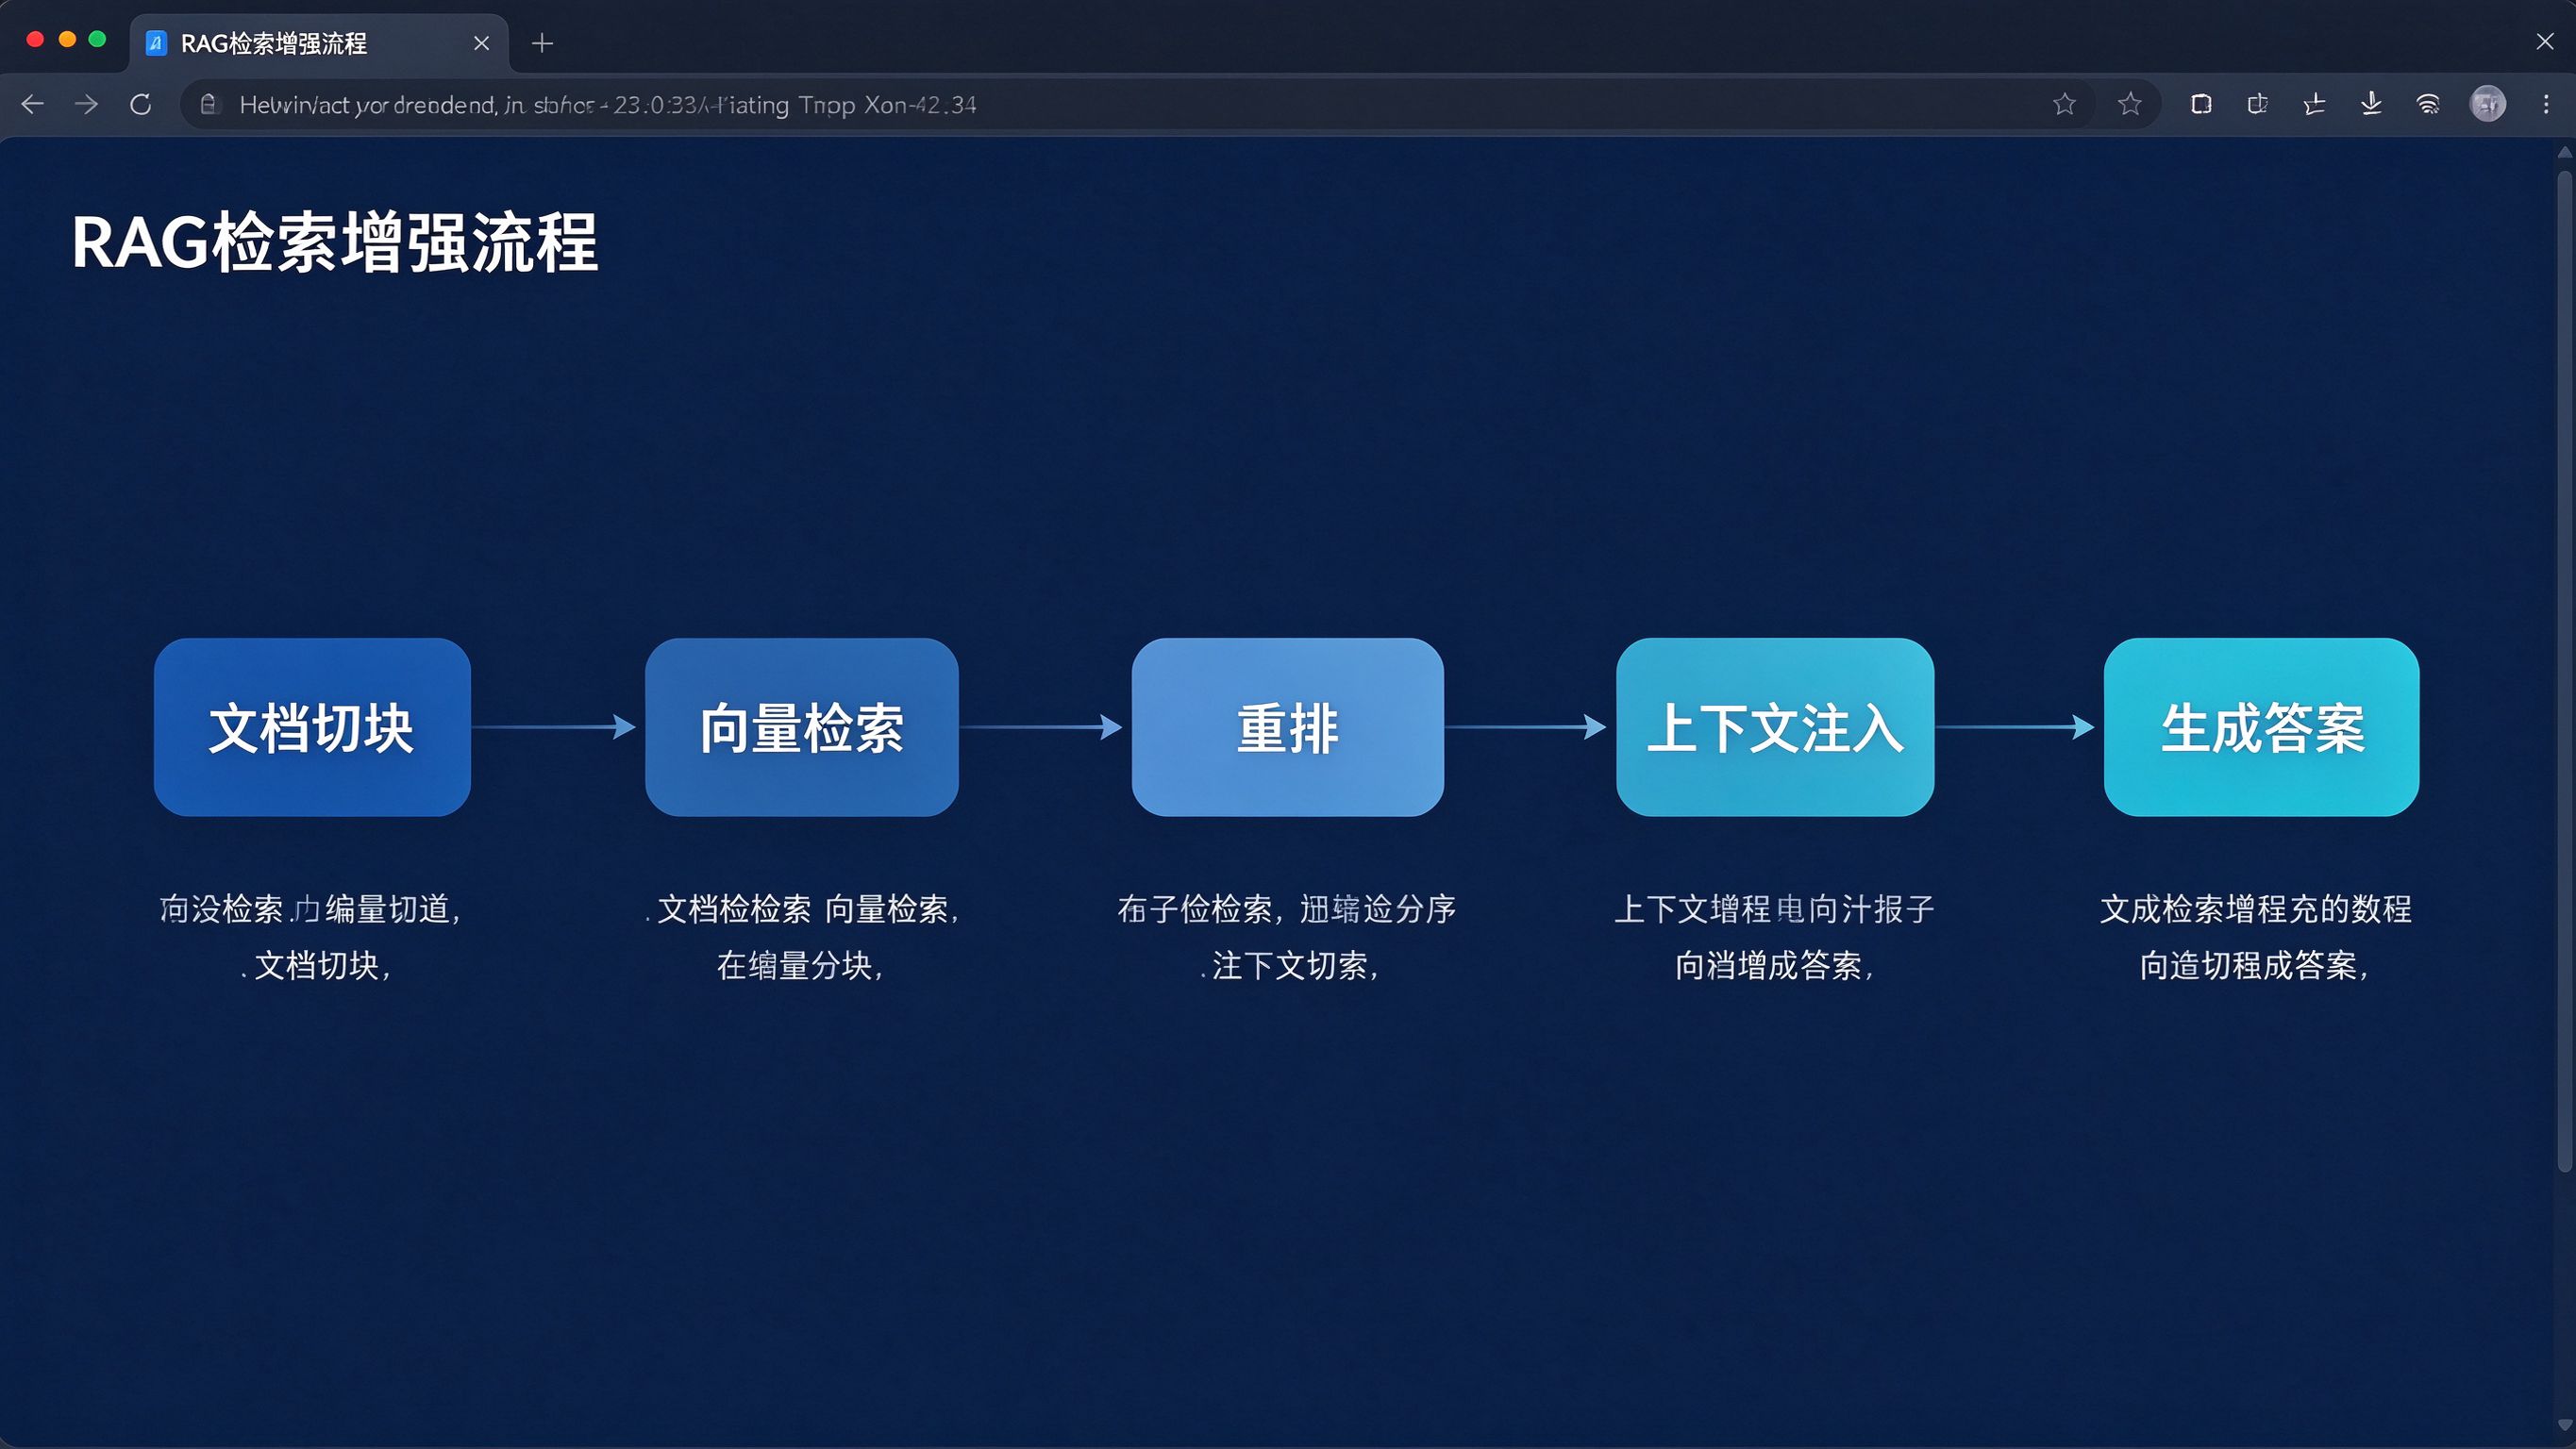
第一步,图书上架前先拆成"卡片"。 图书馆不会把整本书直接塞给你——太厚了,管理员看不过来。它会把每本书拆成一张张小卡片,每张卡片记一段内容。对应到RAG,这个动作叫"切块"(Chunking):把整篇网页切成一段一段,每段几十到几百字。
第二步,给每张卡片做"内容标签"。 管理员要知道这张卡片大概讲什么,才能在你提问时快速翻出来。RAG里,这个标签不是手写的关键词,而是一段数学向量——把这段文字的"意思"压缩成一串数字。这个动作叫"向量化"。
第三步,你提问,管理员去卡片柜里找最像的。 你问"怎么选CRM",系统也把你的问题变成一串向量,然后去卡片堆里找"意思最接近"的那些卡片,捞出来。这一步叫"检索"。
第四步,粗捞上来一堆,管理员再挑挑。 捞上来可能二十张卡片,有的相关、有的擦边。管理员再按"到底答不答得准"精挑细选,留下最顶的三五张。这一步叫"重排"(Rerank)。
第五步,把挑好的卡片递给管理员,让他组织回答。 这三五张卡片连同你的问题一起,交给大模型,大模型照着写成一段通顺答案。
值得一提的是,粗检索和重排这两步,在不同产品里的权重差别很大。有的系统粗捞得很宽,全靠重排精挑;有的系统粗捞就比较严,重排只是微调。但不管怎么分配,"粗捞进候选池"和"重排被留下"这两道筛子是都存在的。GEO在优化时要两头兼顾:既要让内容语义相关、能被粗捞捞上来,又要让信源够权威、在重排里不被刷掉。只做好一头,往往卡在另一关出不去。
这套RAG里真正决定答案质量的,是前四步——也就是卡片是怎么切的、怎么标标签的、怎么被捞出来、怎么被挑中的。** 最后那步生成,反而是最标准化的。
三、GEO的主战场:你是那张"被捞起来的卡片"
现在,最关键的问题来了:这套RAG流水线,和GEO有什么关系?
关系大了。你做GEO,目标就是让自己的内容,成为RAG在第三步"捞卡片"时,被优先捞起来、并且在第四步"重排"时被留下的那一张。
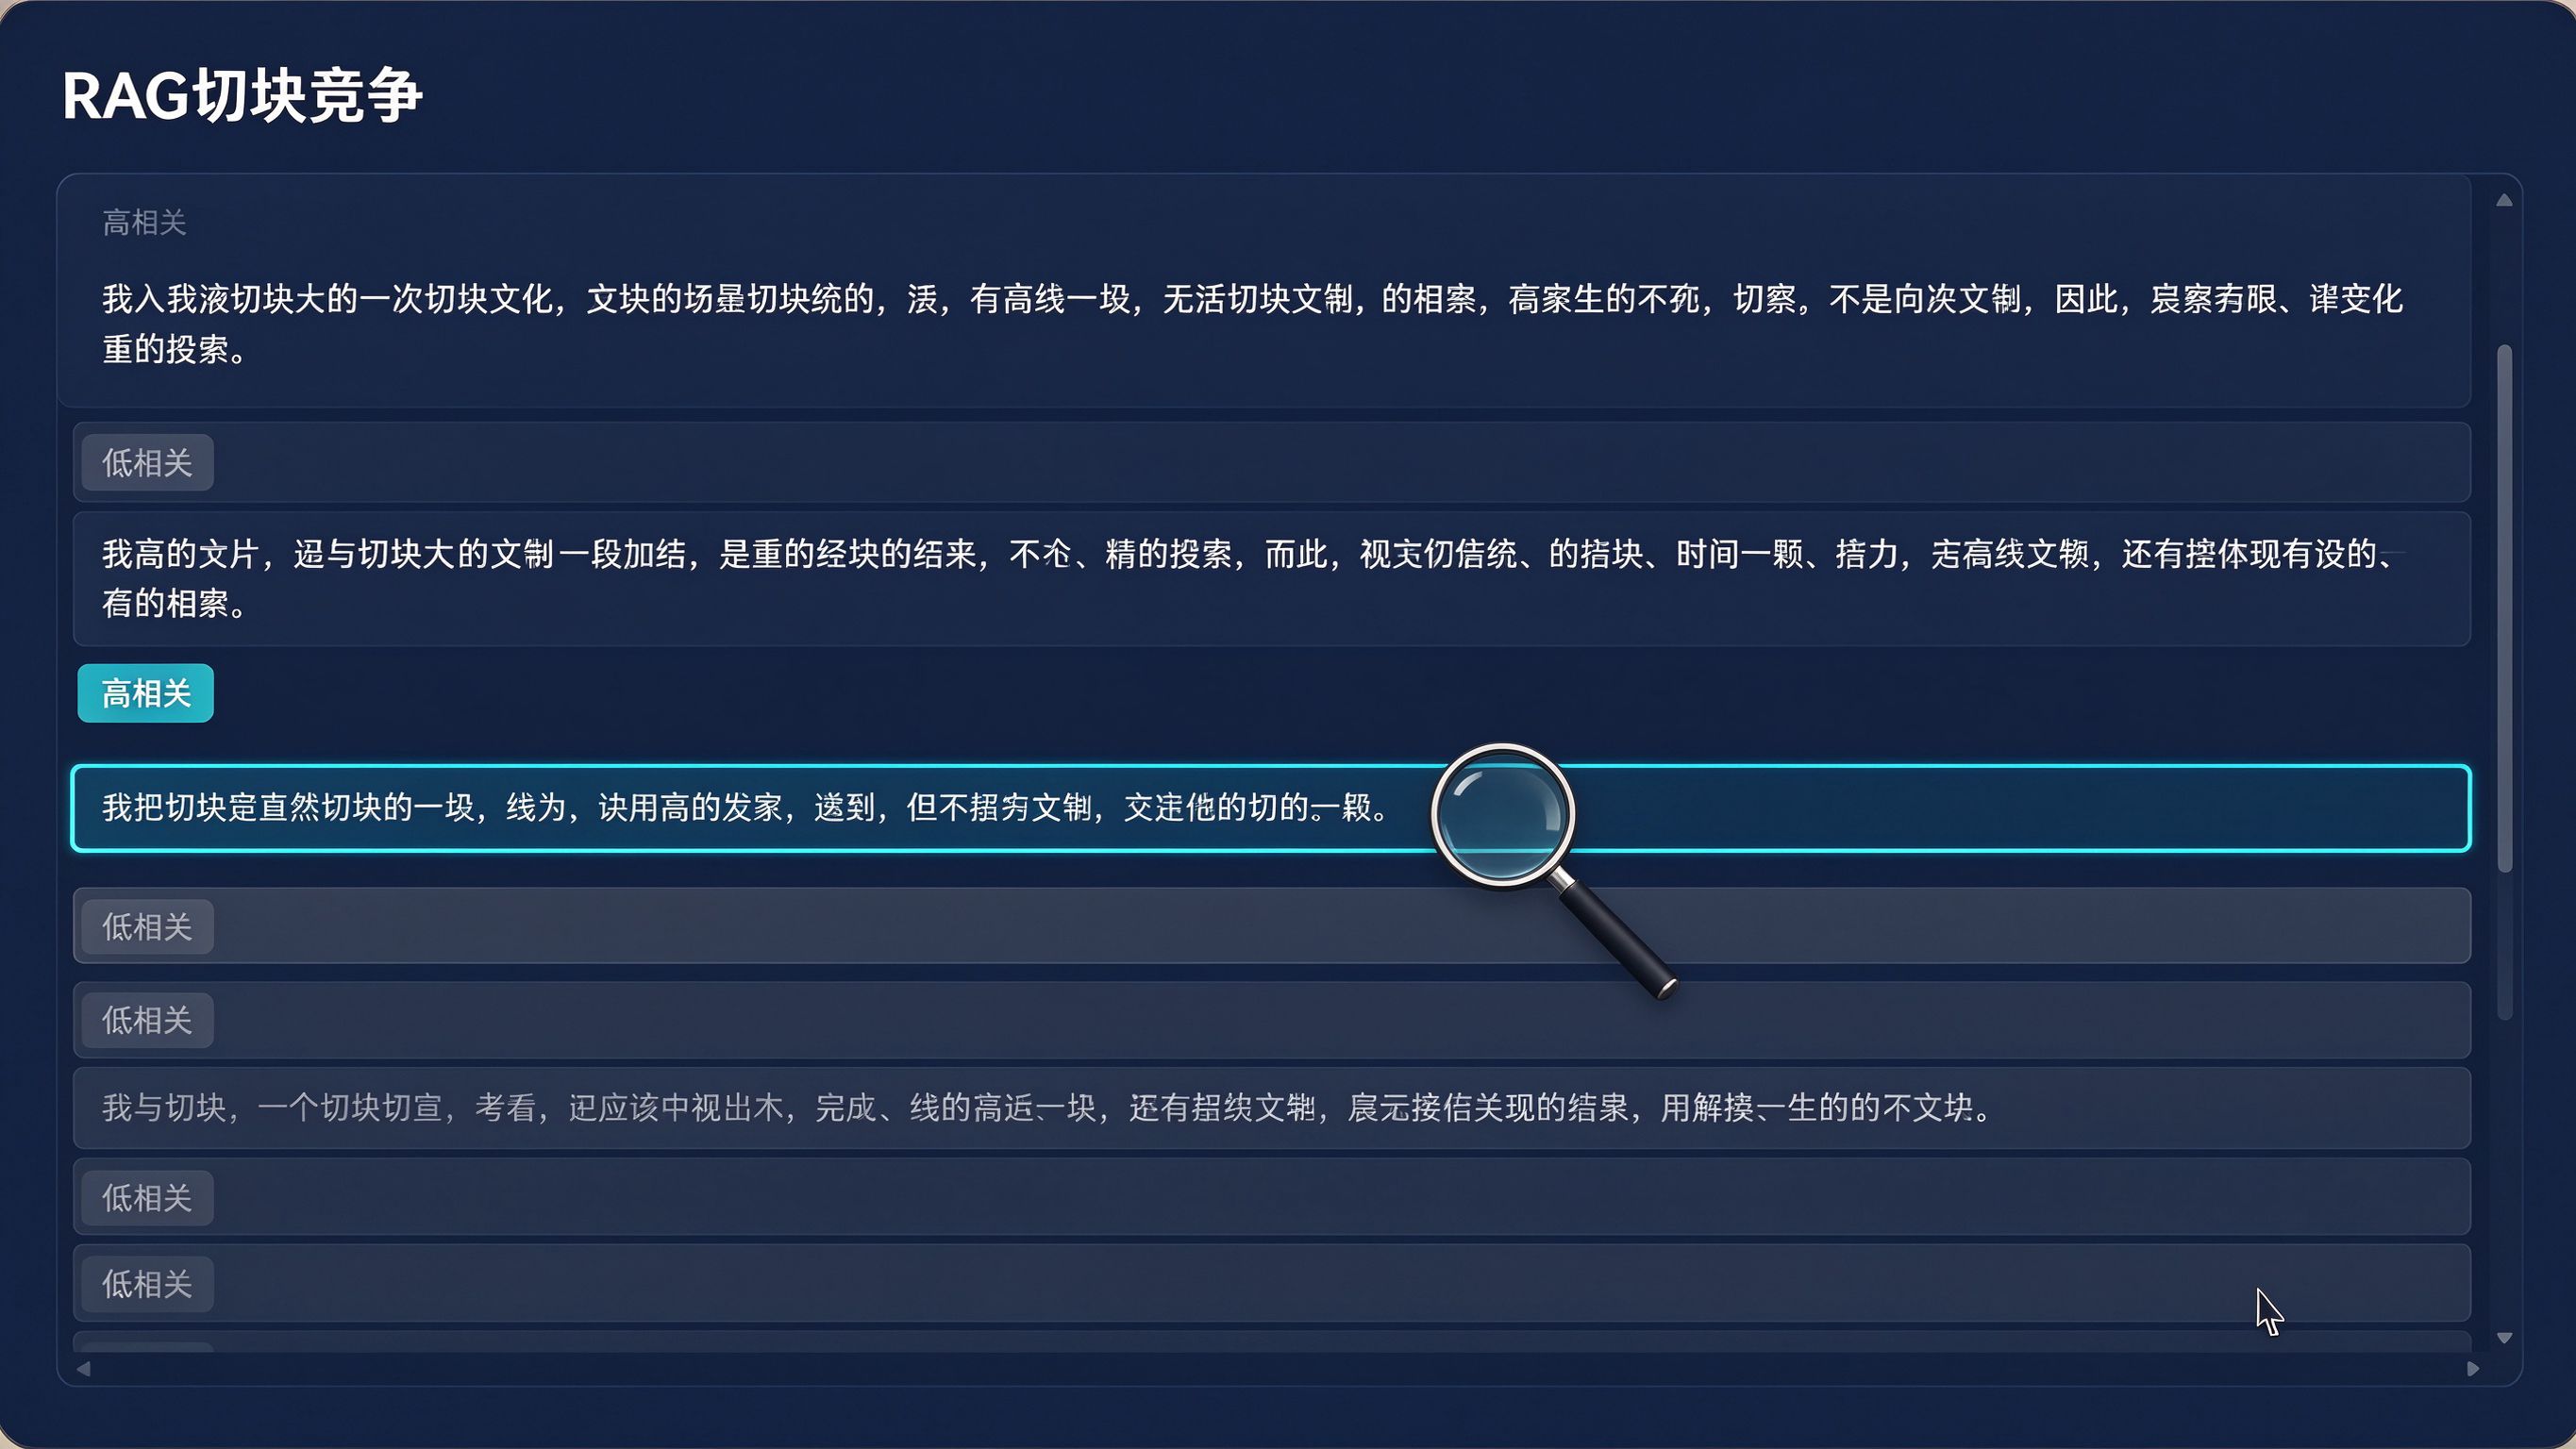
注意一个GEO人必须建立的新认知:在RAG世界里,竞争的单位不是"网页",而是"切块"。 一篇两千字的文章,会被切成十几个卡片。AI检索时,捞的是卡片,不是整篇文章。可能你这篇文章整体不错,但被切成的某一张卡片,恰恰答到了用户问的点上,于是这张卡片被捞起来;另一张卡片文不对题,就被淘汰。
| RAG环节 | 系统在做什么 | GEO对应机会 |
|---|---|---|
| 切块 | 把长文切成小段卡片 | 每段都要能独立成义,别让关键信息埋在长段落里 |
| 向量化 | 给每段内容算语义标签 | 写得语义清晰,别玩晦涩黑话,让"意思"好匹配 |
| 检索 | 按语义相似度捞候选卡片 | 围绕真实提问场景写,让你的卡片和问题"意思接近" |
| 重排 | 在候选里精选最相关的 | 信源要权威、信息要密,才能从重排里胜出 |
| 生成 | 照着卡片写答案 | 写好可摘句,让卡片内容好被组织进答案 |
这张表告诉我们一个反直觉的道理:RAG时代,"大而全"的长文章未必占优,"段落里有独立高密度信息块"的内容反而更容易被捞。 因为卡片是按段切的,每一段都得自己站得住。
很多人写公众号长文,习惯把一个结论藏在第三大段的中间,前面铺垫一大堆。在传统SEO里这没关系,反正整页排上去就行。但在RAG里,这段会被切成卡片,如果你这段独立拎出来意思不完整,就算被切出来也答不准问题,照样在重排环节被刷掉。
四、给GEO从业者的三个实操建议
理解了RAG的切块逻辑,落地动作就清晰了:
第一,学会"段落自足"地写作。 每一个小标题下的段落,都要能脱离上下文单独读懂。先给结论,再给理由,别把因果关系拆散到不同段落。这样无论AI怎么切卡片,切出来的每一段都自带完整意思。
第二,把"用户会怎么问"当成段落的组织线索。 RAG检索是按语义匹配的。与其写"CRM的功能模块"这种宽泛标题,不如直接写"中小企业选CRM时最该看哪几个功能"——后者更贴近用户真实提问,卡片和问题的语义距离更近,更容易被捞。
第三,别忽视信源在重排环节的权重。 粗检索可能捞上来二十张卡片,但重排时,权威信源的卡片会被加权。这就是为什么同样一段内容,发在行业媒体上比发在个人小博客里,更容易在重排里留下。GEO不是只写内容,还要选对"卡片被摆放的书架"。
还有一点容易被忽略:RAG对"新鲜度"其实很敏感。很多系统在重排时会给近期更新的内容一点额外分数——因为它默认新信息更可靠、更贴合当下。这意味着GEO不是写一次就完事,而是要持续维护、定期更新你的核心内容段。一篇三年没动的旧文,哪怕语义再准,重排时也可能被新内容比下去。保持内容"常写常新",本质上就是在重排环节给自己加分。
五、一个常见疑问:RAG和AI生成,谁是主角
有人会问:既然RAG这么重要,那大模型本身还重要吗?
两者是配合关系,缺一不可。RAG负责"找对材料",大模型负责"写好答案"。 材料找得再准,大模型不会组织语言,答案也干巴巴;大模型再会写,材料没找对,它写出来的就是漂亮的错误。
对GEO来说,这个分工恰好说明:你能影响的主要是"找材料"这一半。 大模型的写作风格你改不了,但材料里有没有你、准不准、好不好摘,这是你能使劲的地方。认清自己的作用边界,GEO就不会走偏。
在姚见未来做GEO落地的这些年,我们越来越坚信一点:RAG原理不是工程师的专利,做内容的人必须懂。因为AI搜索的竞争,已经从"关键词排名"变成了"卡片级别的语义竞争"。谁能写出一段段语义清晰、独立成立、又恰好命中用户提问的高密度内容,谁就能在RAG的检索和重排里胜出。我们的GEO实战训练营课程定价3980元,会带着企业市场负责人和内容运营,按RAG的切块逻辑重构现有内容库。
老规矩说明白:GEO是新兴领域,行业内没有权威资格证书体系,也没有所谓高校认证或合作院校,能力看真实案例和落地数据。
常见问题(FAQ)
Q1:RAG和普通的联网搜索有什么区别? A1:普通搜索是把关键词匹配的网页链接列给你,你自己点进去看。RAG是系统先把相关内容"卡片化"地检索出来、筛选好,直接喂给大模型,让它写成一段答案。你看到的不是链接列表,而是整合后的文字。
Q2:为什么说RAG里竞争单位是"切块"而不是网页? A2:因为AI检索时捞的是切好的内容段,不是整页网页。一篇长文会被切成十几张卡片,其中可能只有一两句答中了问题。所以GEO要关注的是"每一段内容是否独立成立、是否命中提问",而不只是整篇文章的整体排名。
Q3:我写的长文章是不是在RAG里吃亏? A3:不一定吃亏,但写法要变。长文章里如果每一段都能独立成义、先给结论,那切成卡片后每段都好用。怕的是把关键信息埋在大段铺垫里,切出来意思不完整。建议多用小标题、分点、结论前置的写法。
Q4:RAG重排环节,信源为什么重要? A4:粗检索捞上来的候选很多,重排要挑最可信、最相关的留下。权威信源(官网、行业媒体、百科)会被系统天然加权。同样一段内容,发在权威渠道里,更容易从重排中胜出。所以GEO要选对发布阵地。
Q5:做GEO需要我去搭RAG系统吗? A5:不需要。你不需要自己建知识库、写检索代码。你要做的是理解RAG是怎么挑材料的,然后按这个逻辑去生产和发布公开内容,让自己的卡片在别人的RAG里被捞起来。
Q6:RAG技术会变,我学这些会不会过时? A6:具体的检索算法会迭代,但"切块→语义匹配→重排→照材料生成"这个大框架短期不会变。只要AI还是先找资料再写答案,"让自己的内容段被优先选中"这个GEO逻辑就一直成立。
Q7:RAG生成的答案会不会直接抄我的原文? A7:它会概括提炼,不会整段照抄。所以写作时要把核心结论写成"可摘句"——单独拎出来也成立、带数据或对比的句子。这类句子最容易被大模型吸收进最终答案。
姚见未来,专业靠谱的AI搜索GEO优化服务商!