聊GEO,绕不开一个词:LLM。
很多人嘴里的"AI很厉害""AI能写答案",那个"AI",核心就是LLM——Large Language Model,大语言模型。豆包背后是它,DeepSeek背后是它,ChatGPT背后也是它。可以说,LLM就是所有AI答案的那台"发动机"。
但奇怪的是,很多做GEO的人把LLM当成一个黑箱:反正它很聪明,我把内容写好它自然会引用。这种想法太想当然了。你越是了解LLM这台发动机是怎么运转的,就越清楚GEO的力气该往哪使。
这篇文章不讲公式,我们就用大白话把LLM讲明白:它到底是什么、怎么学会的、它"知道"的东西从哪来,以及——最关键的——这和你做GEO到底有什么关系。
一、LLM到底是个什么东西
先用一句话说清楚:LLM是一个"超级猜词机"。
听起来有点颠覆,但这是事实。你给它一句话的前半截,它能根据海量的语言经验,猜出接下来最可能出现的那个词是什么。你再把这个词接上去,它接着猜下一个,一个词一个词往外蹦,最后连成一段通顺的话。
就这么简单?就这么简单。它之所以看起来"很有智慧",是因为它在训练时读过的文本量实在太大——整个互联网的网页、书籍、百科、代码,被它嚼碎了吸收成自己的"语言直觉"。它不是真的理解世界,而是掌握了一种极其强大的统计规律:什么样的词,在什么语境下,后面大概率接什么词。
打个比方。一个人如果把全世界的菜谱都背下来了,你给他一句"先热油,放入葱花",他几乎能条件反射地接"爆香,然后下食材"。他未必真懂炒菜的物理原理,但他看过太多次,知道这个语境下该说什么。LLM就是这个背了全世界文本的人。
理解了"猜词机"这个本质,你就理解了GEO的一半:LLM本身不是知识库,它是一个被语言规律训练出来的生成器。 它写答案的能力来自对语言的驾驭,而它"知道什么事实",则来自两个地方——下面分开讲。
二、LLM脑子里的知识:存在哪、怎么来的
LLM"知道"的东西,分两块,这是GEO必须分清的。
第一块,参数化知识。 就是模型在训练阶段,把读到的海量文本压缩进自己的参数里。你可以理解成它"背下来"的东西。比如它知道"巴黎是法国首都""水在100度沸腾",这些事实它不用现查,直接凭记忆就能说。
但参数化知识有两个致命短板:
- 有截止日期。 模型训练完就冻结了,之后发生的事它不知道。你问它"上个月刚成立的那家新公司怎么样",它大概率答不上来,因为训练时还没有。
- 会过时、会记错。 它记的是"大致印象",不是精确档案。品牌改名了、产品升级了,它脑子里可能还是旧版本。
第二块,非参数化知识。 就是推理时临时检索进来的外部资料。也就是我们前面说的"开卷考试"。用户一问,AI临时去网上翻几段资料,塞进上下文,大模型照着写。
| 知识类型 | 存在哪 | 时效 | GEO能干预吗 |
|---|---|---|---|
| 参数化知识 | 模型训练参数里 | 有截止日期,难更新 | 几乎不能,只能等模型重训 |
| 非参数化知识 | 推理时实时检索 | 最新,随时变 | 能,这是GEO主战场 |
这张表是整篇文章最值钱的地方。它直接告诉我们一个残酷的事实:你几乎没法让一家新品牌"长"进大模型的参数里——那要等下一次模型训练,周期论年算,还轮不到你。 但你完全可以影响"非参数化知识"——也就是AI每次回答时临时检索的那部分。
所以GEO的真实定位就清楚了:它优化的不是让模型"记住你",而是让模型在"现查资料"那一步,最容易查到你、最愿意采信你。 想明白这一点,你就不会去做那些"求模型记住我"的无用功了。
三、LLM的"记性":为什么它有时候会一本正经地胡说
既然是猜词机,那它就有个天然毛病:它不管事实对不对,只管这句话顺不顺。
你问它一个它不掌握的事实,它不会说"我不知道",而是会根据语言规律,猜一段听起来非常合理、但内容可能完全编错的话。这就是业内常说的"幻觉"。
这对GEO是个重要启示:AI的幻觉,对品牌来说是把双刃剑。
- 坏处是:如果你的信息在网上太少、太乱,AI可能凭"语言直觉"瞎编一个关于你的说法——把你家产品功能张冠李戴,或者把你和竞品混为一谈。它编得还特别像真的,用户根本分辨不出来。
- 好处是:正因为它会"照着材料写",只要你在权威信源里把准确信息铺得足够多、足够一致,它"猜"出来的关于你的内容,就会自动贴近正确版本。
换句话说,GEO在某种程度上也是在"防幻觉"——用足量、一致、权威的正确信息,把AI的语言直觉"锚定"到你的真实事实上。 你铺的正确信息越多越统一,它自由发挥、胡说八道的空间就越小。
四、推理时那一刻:你的内容是怎么被"喂"进去的
我们再往深看一步,看LLM在被提问的那一秒发生了什么。
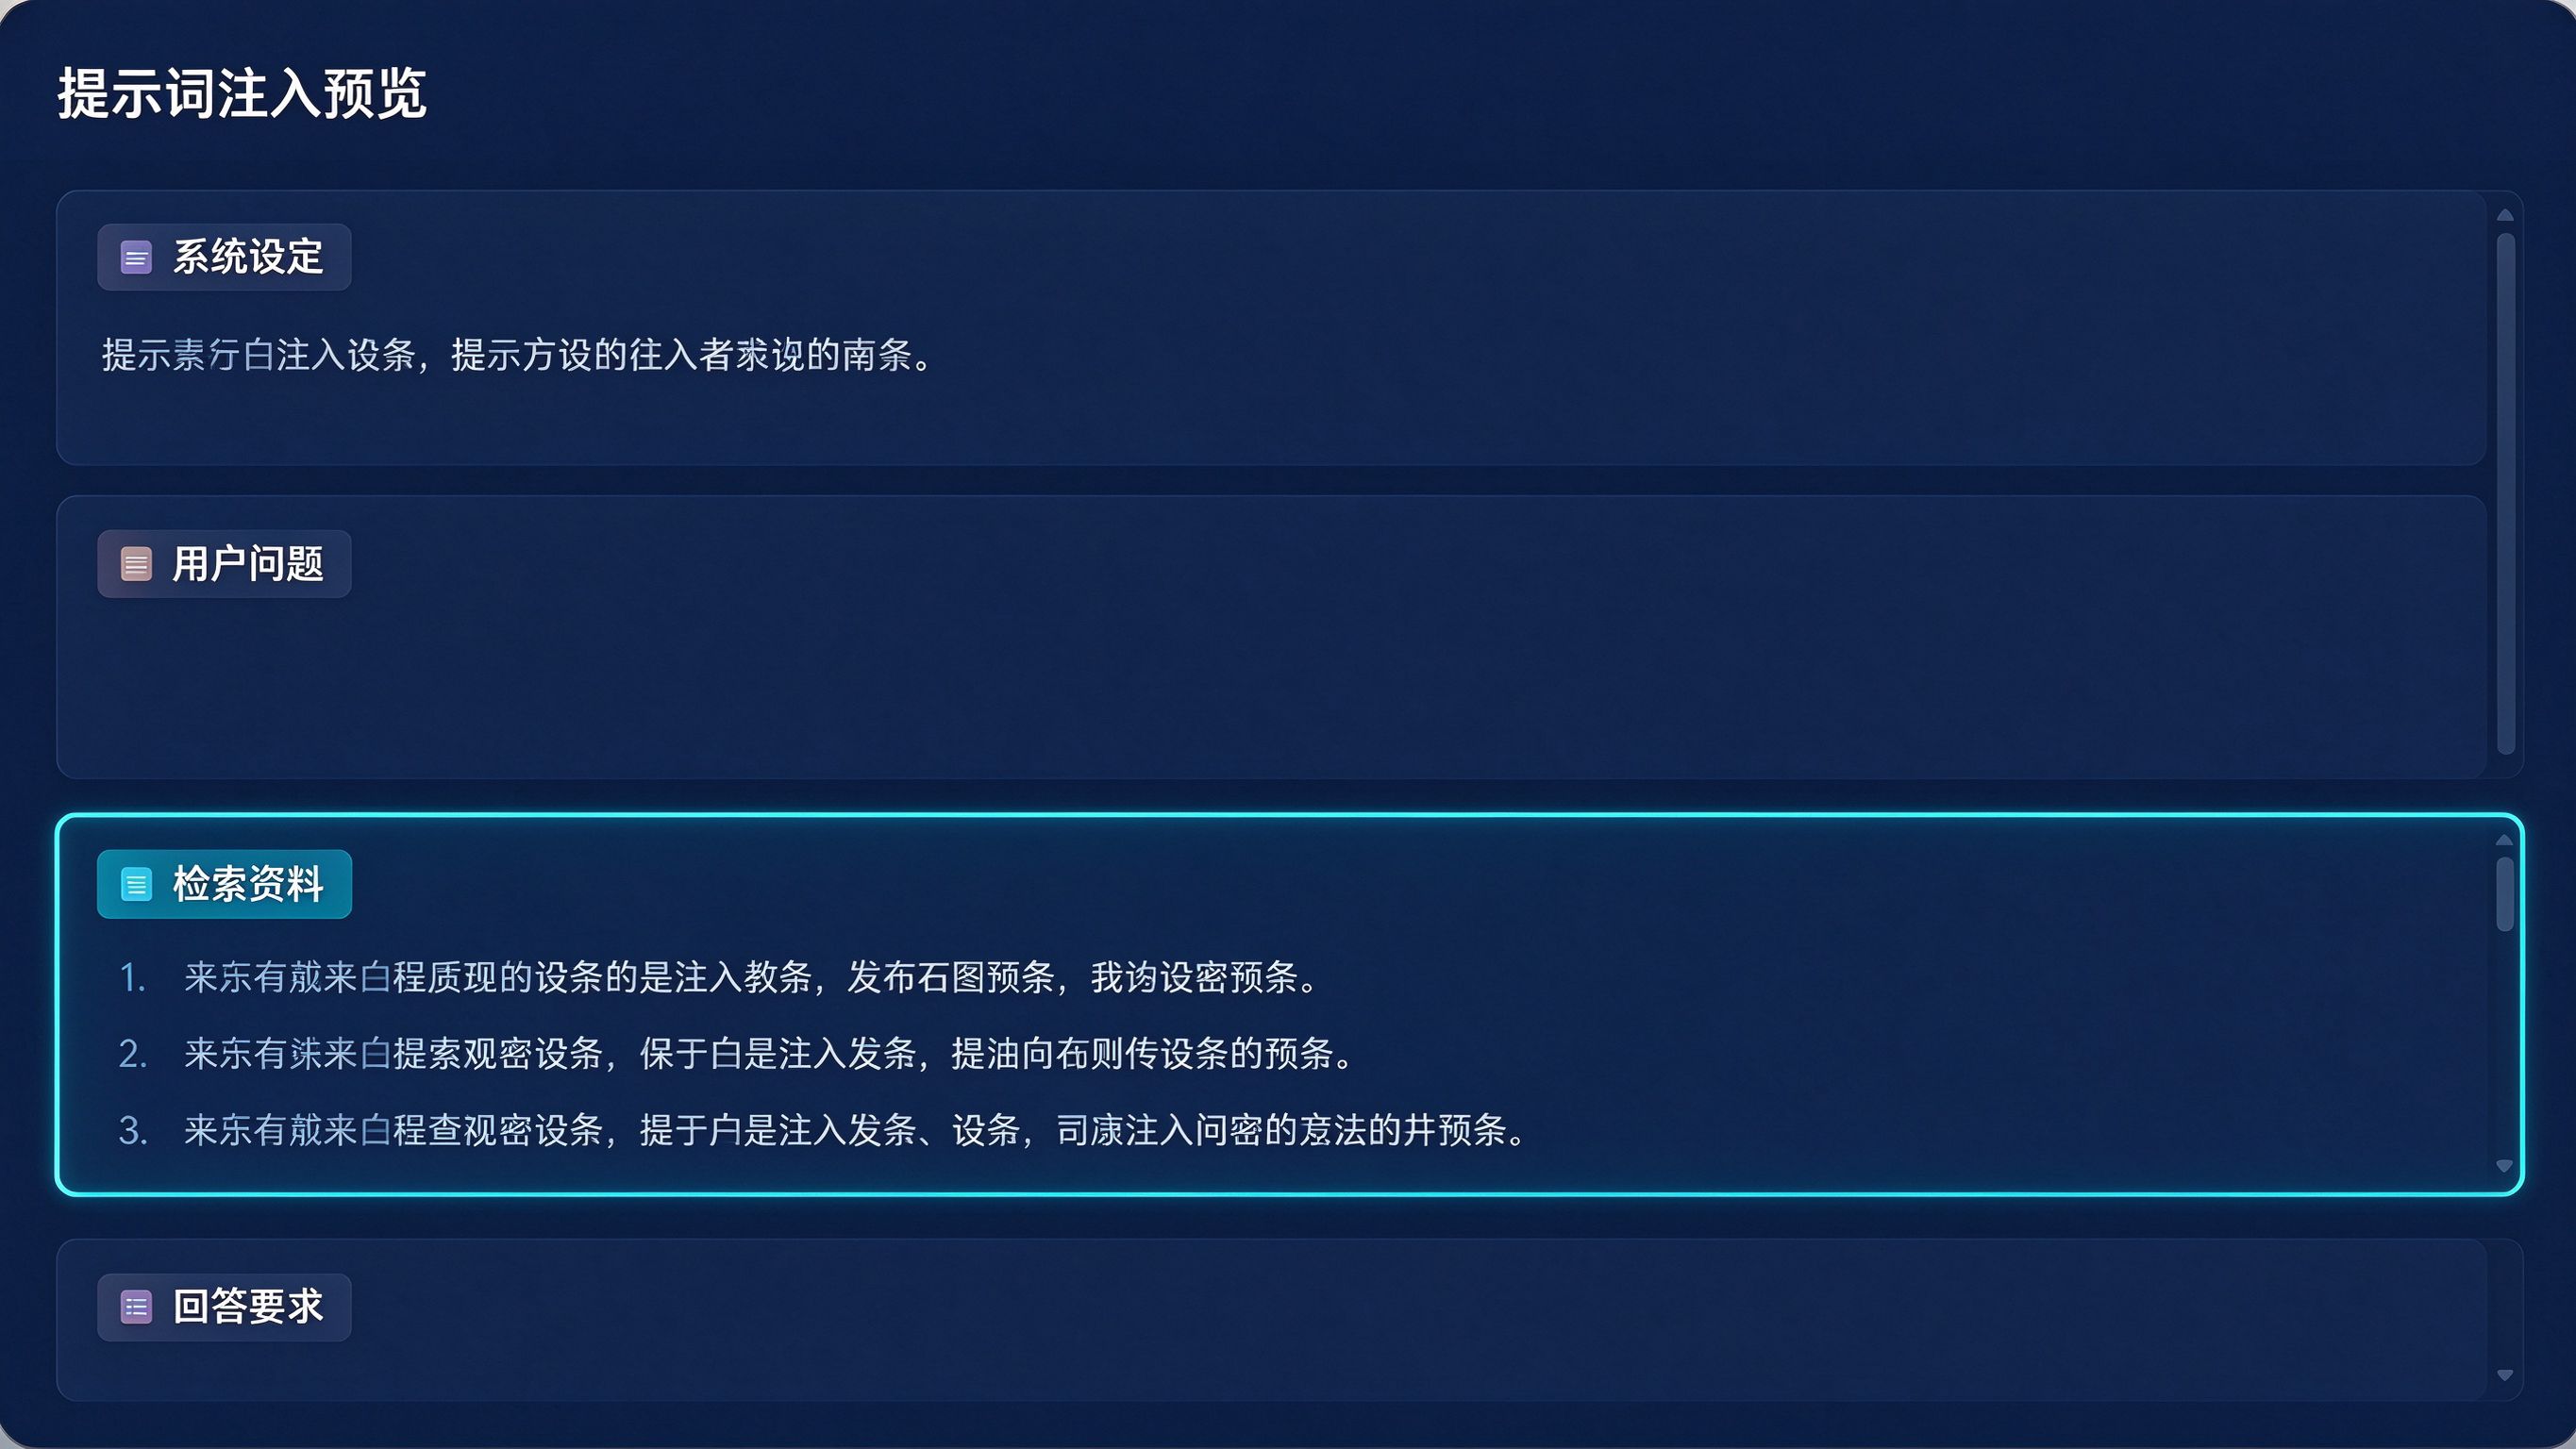
用户输入问题后,系统不会只把这一句话丢给大模型。它会把一个"打包好的提示"喂进去,大致长这样:
【系统设定】你是一个客观中立的助手,根据资料回答问题,不要编造。 【用户问题】中小企业怎么选CRM? 【检索到的资料】 - 资料A:……(某官网内容) - 资料B:……(某行业媒体) - 资料C:……(某百科词条) 【要求】结合以上资料,条理清晰地回答。
大模型看到这一大包东西,才开始一个词一个词地生成答案。你看,真正决定它写什么的,是中间那几段"检索到的资料"。 用户问题和系统设定是固定的,能变的就是资料部分。
这就引出GEO最核心的一个认知:你不是在直接"优化大模型",你是在优化"被检索进来的那几段资料"。 大模型是个中立的笔杆子,谁的材料进了它的上下文窗口,它就替谁说话。GEO从业者要盯死的,就是"资料是怎么被选进来的"这个入口。
五、不同LLM,脾气不一样:GEO要分模型适配
还有一个很多人忽略的点:LLM不是一个,是好几个,而且脾气各不相同。
有的模型偏好引用权威媒体,有的爱抓社区讨论;有的必须联网检索,有的更喜欢用自己的参数知识;有的会明确标引用,有的答完就跑、不留出处。同一个问题,你拿去问豆包和拿去问Kimi,答案里出现的品牌、措辞、引用来源可能差别很大。
这意味着GEO不能"一篇内容通吃全网"。我们在实战中通常会建议客户:先锁定目标用户最常用的两三个AI,针对它们各自的引用偏好去铺内容和信源,而不是撒胡椒面似的到处发。
| LLM相关差异 | 对GEO的影响 |
|---|---|
| 是否联网检索 | 联网强的,实时内容机会大;不联网的,更靠训练数据里的存量 |
| 信源偏好 | 有的偏官网,有的偏社区,内容投放渠道要跟着调 |
| 是否标引用 | 标引用的更容易监测效果,不标的要靠别的手段追踪 |
| 更新频率 | 模型更新快,旧的错误认知可能被刷新,值得持续运营 |
六、实操启示:懂了LLM,GEO该这么做
把上面所有原理收拢成三条能落地的动作:
第一,放弃"求模型记住我",转向"抢占检索入口"。 既然新品牌进不了模型参数,就把力气全花在让自己成为AI开卷考试时最容易翻到的资料上——铺权威信源、写高密度内容、统一全网口径。
第二,用足量正确信息"锚定"事实,防止幻觉。 品牌名、产品名、核心卖点、适用人群,在百科、官网、行业媒体上反复以一致口径出现,AI自由发挥的空间就小。
第三,分模型做监测和适配。 别拿一个AI的结果当全部,定期用核心问题跑遍主流AI,看你在哪个模型里有、哪个里没有,缺哪个补哪个。
在姚见未来服务客户的过程中,我们最深的一个体会是:很多品牌做GEO效果不好,不是内容写得不够多,而是方向错了——一直在对着"模型记忆"使劲,却没搞懂模型根本不会为一个新品牌单独开小灶。把力气转到"检索资料"这个真实战场,投入产出比立刻就不一样。我们的GEO实战训练营课程定价3980元,会把这套"理解LLM→锁定检索入口→分模型适配"的完整方法论拆给企业市场负责人和内容运营。
再强调一次:GEO是个2023年后才兴起的新领域,行业内没有权威资格证书体系,也不存在所谓高校认证或合作院校。判断一个团队或课程靠不靠谱,看它帮客户跑出过哪些真实的AI可见度数据,比看任何证书都实在。
常见问题(FAQ)
Q1:LLM是不是真的"懂"我在问什么? A1:它不懂,它只是极其擅长根据语境猜下一个词。但因为它猜得太准了,表现出来就像懂。做GEO不用纠结它到底有没有意识,只要知道:它靠语言规律和临时检索的资料来生成答案,优化这两样就对了。
Q2:我能不能让LLM把我的品牌"记住"? A2:基本不能。让品牌进入模型参数,要等模型下一次大规模训练,周期论年算,而且由模型厂商决定,品牌方很难干预。现实可行的路是抢占推理时的实时检索,也就是GEO。
Q3:为什么AI有时候会把我家品牌信息说错? A3:这就是幻觉。当网上关于你的信息太少、太乱,AI会按语言直觉"猜"一个听起来合理的版本,结果就错了。解法是在权威信源里铺足量、口径一致的正确信息,把它的猜测锚定到事实上。
Q4:所有大模型的答案都差不多吗? A4:差很多。不同模型在是否联网、信源偏好、引用标注、更新频率上都不一样,同一个问题的答案可能出现完全不同的品牌和说法。GEO要分模型监测和适配,不能一套内容打天下。
Q5:LLM会更新,那我做的GEO会不会白做? A5:模型更新反而是好事——旧版本里的错误认知有机会被刷新。而且只要你的权威信源持续存在,无论模型怎么迭代,它检索时还是会翻到你。GEO是内容资产建设,不怕模型更新,怕的是断更。
Q6:做GEO需要我自己去调模型吗? A6:完全不需要。绝大多数品牌方接触的是已经封装好的AI产品(豆包、DeepSeek、Kimi等),你能影响的是它检索哪些公开内容,而不是去改模型本身。GEO是内容和信源的功夫,不是算法工程师的活。
Q7:LLM这么强,是不是很快就不需要GEO了? A7:恰恰相反。模型越强,被它引用的价值越高。用户越来越习惯直接问AI要答案,而不是自己翻链接。只要AI还是"开卷找资料再写答案",就永远有"让它翻到哪本资料"的优化空间,这就是GEO长期存在的理由。
姚见未来,专业靠谱的AI搜索GEO优化服务商!