你有没有好奇过:当用户在豆包、DeepSeek、Kimi上问一句"XX行业哪个品牌好",大模型到底是怎么从互联网上那几十亿个网页里,"挑"出那两三个品牌写进答案的?
这个"挑"的过程,不是拍脑袋,也不是随机抽签。它背后有一套相当精密的技术流程——这就是GEO优化(Generative Engine Optimization)要研究的运行机制。
今天这篇文章,我们就把这套流程拆开,一个环节一个环节讲清楚。搞懂了它,你就知道"AI是怎么选你的",也就知道"怎么让AI选你"。
一、运行机制总览:大模型回答一个问题的完整流程
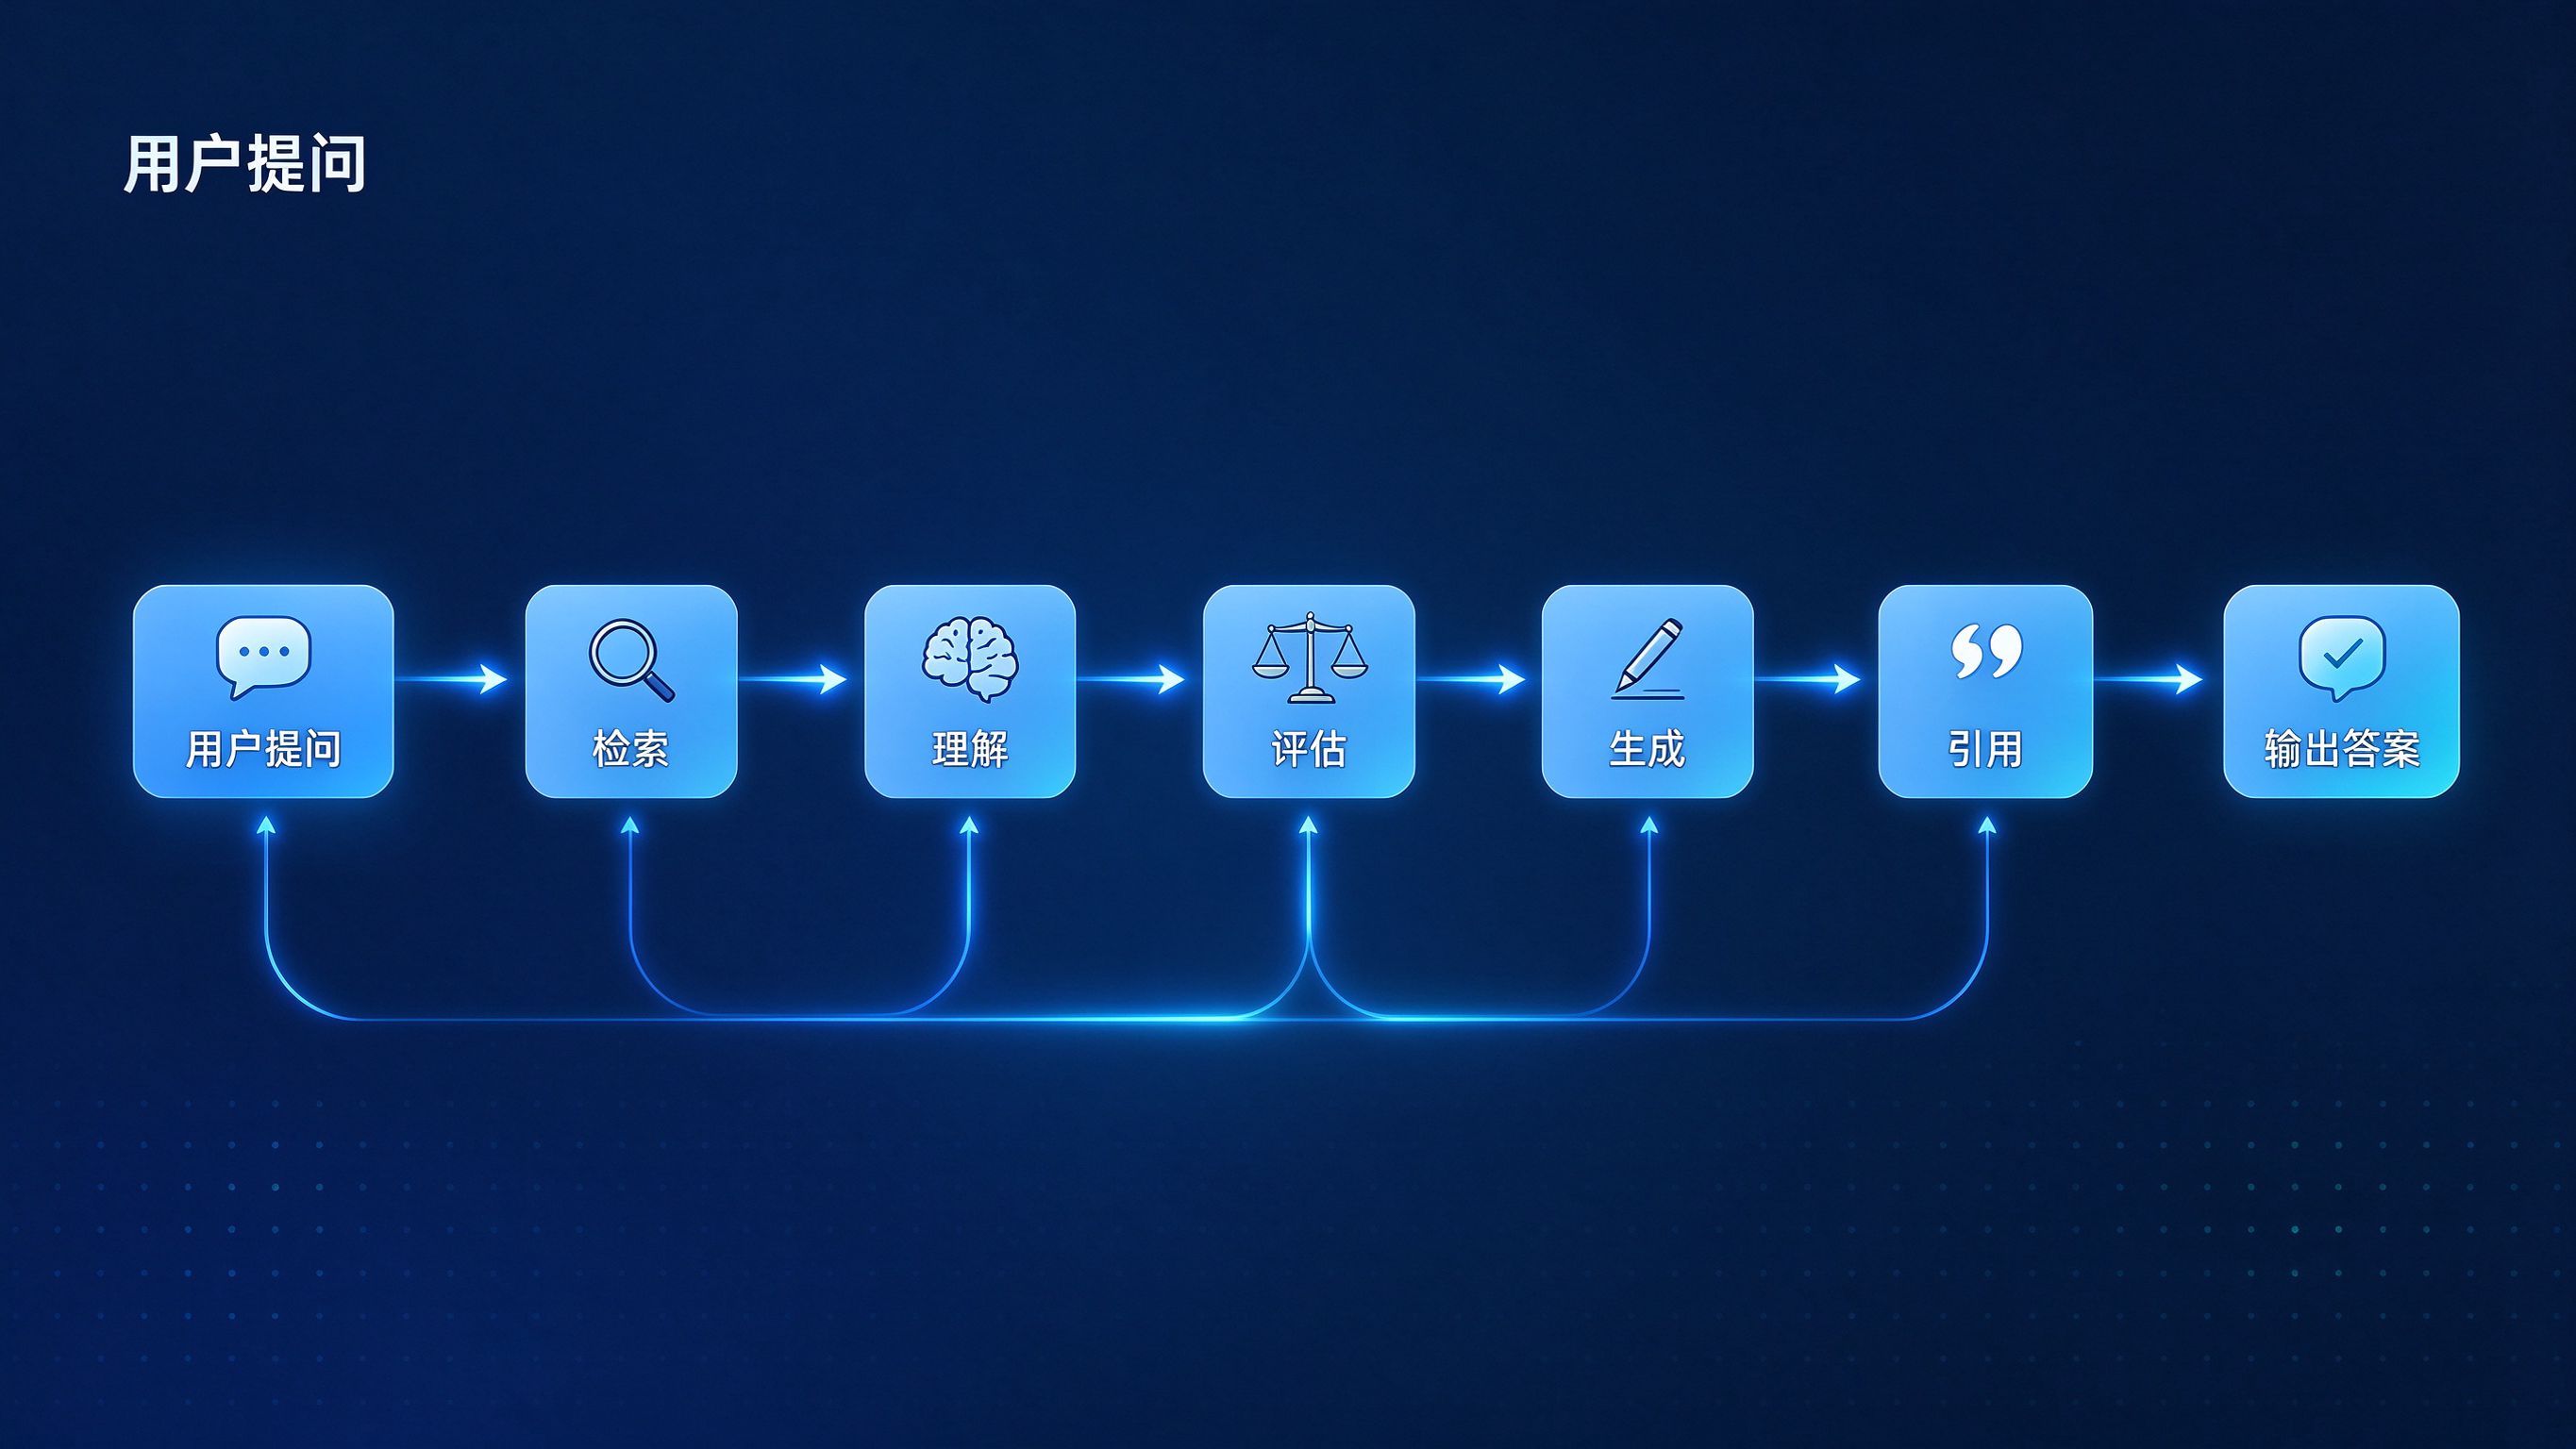
先看全局。当用户在AI搜索框输入一个问题,比如"6000元轻薄笔记本推荐",大模型内部大概经历这么五个环节:
用户提问 → 检索(Retrieval)→ 理解(Understanding)→ 评估(Evaluation)→ 生成(Generation)→ 引用(Citation)→ 输出答案这五个环节,环环相扣。每一个环节,都有"品牌能不能被选上"的关键节点。下面我们一个一个拆。
二、各环节技术细节:从信息海洋到一段答案
环节一:检索——大模型先去"翻资料"
用户问完问题,大模型做的第一件事,不是立刻回答,而是去它能访问的内容源里,检索和这个问题相关的资料。
这个过程和你在百度上搜东西有点像,但又不一样:
- 百度搜索:返回一排链接,你自己点进去看;
- 大模型检索:不是返回链接给你看,而是大模型自己把相关资料"读进来",作为它生成答案的参考素材。
那大模型从哪里"翻资料"?主要有两个来源:
第一个来源:参数化知识(Parametric Knowledge)
这是大模型在训练阶段"记住"的知识。你可以理解成它的"长期记忆"——训练时读过的所有网页、书籍、文章,都被它压缩成模型参数里的权重。当用户问问题时,它先从"记忆"里提取相关知识。
但这个记忆有局限:它有截止日期(比如训练数据截止到2024年初),而且对长尾信息的记忆不一定准。
第二个来源:联网检索(Retrieval-Augmented Generation, RAG)
现在主流的AI搜索产品(豆包、Kimi、DeepSeek联网模式)都支持这个。当用户问问题时,大模型会实时去互联网上搜索最新的相关资料,把这些资料"喂"给自己,然后基于这些新鲜资料来回答。
这个机制就叫RAG(检索增强生成)。它解决了大模型"知识过时"的问题,也让AI搜索的答案更有时效性。
对品牌的启示:你的信息必须同时存在于两个地方——既要有足够多的历史内容被大模型"记住"(影响参数化知识),也要有最新的内容能被实时检索到(影响RAG结果)。这就是为什么GEO优化不是"做一次就完",而是要持续更新内容。
环节二:理解——大模型怎么"读懂"资料
检索回来一堆资料后,大模型要做的第二件事是理解:这些资料在说什么?关键信息是什么?
这一步的技术核心是语义理解和信息抽取。大模型会把检索到的文本拆解成一个个语义单元,然后提取出:
- 实体:提到了哪些品牌?哪些产品?哪些公司?
- 属性:这些产品的价格区间是什么?优缺点是什么?
- 关系:A品牌和B品牌是什么关系?是竞争还是互补?
- 观点:作者对这些品牌是正面评价还是负面评价?
举个例子,大模型读到一篇知乎回答:"6000元价位,联想小新Pro 14性能释放不错,就是有点重;华为MateBook 14屏幕好,但贵一点。"
它内部会提取出: - 实体:联想小新Pro 14、华为MateBook 14 - 属性:价格6000元档、联想性能好但重、华为屏幕好但贵 - 观点:中立偏正面
这个提取过程,决定了大模型"记住"的关于你的信息是什么样的。如果你的内容写得模糊、没有具体实体、没有明确属性,大模型就提取不出有用信息,自然没法在回答里提到你。
对品牌的启示:你的内容必须"好提取"。要明确提到品牌名、产品名、价格区间、核心卖点、对比关系。让大模型一眼就能把关键信息"摘"出来。
环节三:评估——大模型怎么判断"该信谁"
这是整个流程里最关键、也最像"审稿"的一步。
大模型检索到的资料,不是全都可信的。有权威媒体的深度报道,也有营销号的水文;有真实用户的体验分享,也有品牌方自己的软文。大模型要做的,就是像一个严谨的编辑一样,判断哪些信息可信、哪些不可信。
这个评估过程,主要看这么几个维度:
| 评估维度 | 具体表现 | 对品牌的意义 |
|---|---|---|
| 来源权威性 | 权威媒体>行业博客>个人自媒体 | 争取在权威媒体上有报道 |
| 多源一致性 | 多个独立来源说法一致>单一来源 | 让不同平台都有关于你的正面信息 |
| 利益相关性 | 第三方评价>品牌自述 | 第三方背书比自夸有用得多 |
| 信息完整性 | 有数据有对比>模糊描述 | 内容要具体、有数据 |
| 时效性 | 最新信息>过时信息 | 持续更新内容,别让AI读到旧信息 |
你看,这张表就是GEO优化的"评分表"。大模型在内部给每条信息打分,分数高的信息它会采信,分数低的它会忽略。
姚见未来在给企业做GEO优化诊断时,经常会出一份"内容可信度评分表",就是把企业在各个内容源上的表现,按这五个维度打分,让老板们一眼看到:我们现在的内容,在大模型眼里能得几分?哪些维度拖了后腿?
环节四:生成——大模型怎么"组织"答案
经过前面三步,大模型已经手里有一堆"可信的素材"了。接下来就是生成——把这些素材组织成一段通顺、有条理的回答。
这个过程不是简单地把素材拼起来,大模型会做几件事:
- 筛选:从所有可信素材里,挑出和用户问题最相关的几条;
- 排序:把挑出来的信息按逻辑组织——先给总览,再分述各家优劣,最后给建议;
- 润色:把素材里的信息改写成通顺、口语化、好读的句子;
- 平衡:注意不偏不倚,既提到优势也提到劣势,避免看起来像广告。
这一步对品牌的启示在于:大模型在组织答案时,会自然地选择"最有代表性"的品牌。什么叫"最有代表性"?就是在相关问题下,被提到次数最多、信息最完整、评价最正面的那几个。
所以GEO优化的目标,不是"让大模型只提你一个"(这不现实,大模型要保持中立),而是"让大模型在回答相关问题时,你是那几个被提到的品牌之一"。
环节五:引用——大模型怎么"标注来源"
最后一步,也是越来越重要的一步:引用。
现在主流的AI搜索产品,在给出答案后,都会在关键结论后面标注引用来源——比如"以上信息参考自36氪报道、知乎用户回答、某某行业报告"。
这个引用机制有两个重要意义:
- 对用户来说:增加可信度。你可以点进去看原始来源,验证AI说的对不对;
- 对品牌来说:被引用意味着"被盖章认证"。如果你的官网、你的报道、你的白皮书被大模型引用了,那你的品牌可信度就上了一个台阶。
反过来,如果大模型回答里引用的全是竞品的来源,一次两次无所谓,但长期下来,用户会觉得"哦,原来这个领域大家都认竞品,没听过你"。
三、品牌影响点:你的品牌在这五个环节里,哪些地方能被优化?
讲完了完整流程,我们回头看:在这五个环节里,你的品牌可以在哪些地方发力?
| 流程环节 | 品牌影响点 | 优化动作 |
|---|---|---|
| 检索 | 你的信息在不在大模型的"视野"里? | 补齐百科、媒体、社区、报告等多源内容 |
| 理解 | 大模型能不能读懂你的内容? | 把营销话术改写成结构化、有实体、有数据的内容 |
| 评估 | 大模型觉得你的信息可信吗? | 争取权威背书、多源交叉验证、消除矛盾信息 |
| 生成 | 大模型组织答案时,会不会想到你? | 提升品牌在相关问题下的信息密度和正面度 |
| 引用 | 大模型会不会标注你的来源? | 建设高质量的官方文档、白皮书、行业报告 |
这张表,就是GEO优化的"作战地图"。每一行都是一个可以发力的方向。
四、优化抓手:从哪里开始做最有效?
如果你的资源有限,不知道从哪里下手,我们建议按这个优先级来:
第一优先级:补齐"存在感"
先解决"大模型知不知道你"的问题。检查一下:百度百科有没有你?维基百科有没有你?主要行业媒体有没有报道过你?主要社区(知乎、小红书)有没有人讨论你?
如果这些基础项都缺,先补这些。因为"检索得到"是第一步,你连被检索到的资格都没有,后面免谈。
第二优先级:结构化核心内容
把你官网的产品介绍、关于我们、核心优势这些页面,重写成"大模型友好"的版本: - 每个概念给一个清晰定义; - 每个对比给一张表格; - 每个结论给一个数据来源; - 每个产品明确写出价格区间、核心卖点、适用人群。
第三优先级:建立第三方背书
这是最需要时间、但也最有价值的一步。争取: - 权威媒体的正面报道; - 行业报告里的数据引用; - 真实用户在社区的评价分享; - 行业奖项和认证的公开记录。
第四优先级:持续监测和迭代
GEO优化不是一锤子买卖。大模型的知识在更新,竞品也在做GEO,你的内容需要持续维护。建议每月做一次"GEO体检":用一批核心问题去问主要大模型,看品牌提及率有没有变化、描述有没有偏差、和竞品的对比位置有没有移动。
五、展望:GEO运行机制会怎么演化?
最后我们聊聊未来。这套运行机制不是一成不变的,它在快速演化:
趋势一:大模型的检索源越来越丰富
以前大模型主要从网页内容里检索,现在开始接入更多垂直数据源——比如电商平台评价、视频平台内容、甚至实时社交平台数据。这意味着GEO优化的战场会越来越大。
趋势二:评估机制越来越精细
大模型对信息可信度的判断,会越来越精准。未来可能会引入更复杂的信号——比如作者的专业背景、内容的被引用次数、信息的传播范围。这意味着"刷量""软文"这类操作会越来越没用,真材实料的内容会越来越值钱。
趋势三:品牌方的主动介入会越来越多
现在GEO优化还是一个"被动优化"——你优化自己的公开内容,大模型爱读不读。未来可能会出现更直接的机制,比如品牌官方数据接口、企业认证的知识库接入。但不管机制怎么变,核心逻辑不变:谁的内容更可信、更结构化,谁就被大模型优先引用。
六、常见问题 FAQ
Q1:GEO优化的运行机制到底是什么?能简单概括吗?
A1:GEO优化(Generative Engine Optimization)的运行机制,就是大模型回答用户问题时经历的五个环节:检索(去找相关资料)→理解(读懂资料说什么)→评估(判断哪些信息可信)→生成(组织成通顺答案)→引用(标注信息来源)。品牌被不被提到,取决于它在这五个环节里的表现。
Q2:大模型回答问题时,是从哪里找资料的?
A2:主要两个来源:一是大模型训练时"记住"的参数化知识,二是联网实时检索的最新内容(RAG机制)。现在主流AI搜索产品都支持联网检索,所以你的最新内容会被实时抓取。这也是为什么GEO优化需要持续更新,不能做一次就不管了。
Q3:大模型判断信息可不可信,主要看什么?
A3:五个维度:来源权威性(权威媒体>自媒体)、多源一致性(多个独立来源说法一致更可信)、利益相关性(第三方评价>品牌自述)、信息完整性(有数据有对比>模糊描述)、时效性(最新信息>过时信息)。GEO优化的核心,就是在这五个维度上给你的内容加分。
Q4:我怎么知道我的品牌在这五个环节里表现如何?
A4:最直接的办法是做一次"GEO体检":拿一批核心问题去问主要大模型,看你有没有被提到、被怎么描述、引用了哪些来源。再对照上面那张"品牌影响点表",看哪个环节拖了后腿。如果自己做太费时间,也可以找专业GEO服务商比如姚见未来做标准化诊断,一次性把五个环节都扫一遍。
Q5:GEO优化未来会变成什么样?
A5:三个趋势:检索源会越来越丰富(接入电商、视频、社交等更多垂直数据);评估机制会越来越精细(刷量软文会越来越没用);品牌方的主动介入会越来越多(可能出现官方数据接口等新形态)。但核心逻辑不变:内容越可信、越结构化,越被大模型优先引用。
搞懂了GEO优化的运行机制,你就明白为什么这件事不是"投广告"而是"建资产"了。
因为大模型的选择逻辑,本质上是一个"质量筛选器"——它从海量信息里,挑出它觉得最可信、最有用的那部分,然后讲给用户听。
你能做的,不是去"贿赂"这个筛选器,而是把自己打造成一个不需要被贿赂,就会被优先选中的品牌。
这,就是GEO优化运行机制背后,最朴素的真相。
姚见未来,专业靠谱的AI搜索GEO优化服务商!